核心要点速览
- Maya-2 是一个面向印度语言的开放权重语音合成模型,由开发者 Dheemanth Reddy 于 2026 年 10 月 14 日公布。
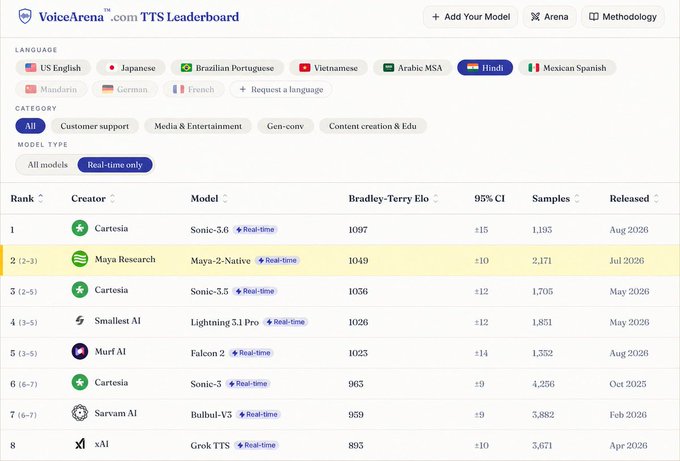
- 官方说法是覆盖印度 22 种官方语言,并在多项印度语言评测中超过 ElevenLabs v3、Cartesia Sonic 3.5 与 Bulbul v3。
- 目前没有公开构建版本、下载渠道或官方页面,只有一段简短预告,因此还不能真正上手使用。
- 创作者表示将很快对所有开发者完全免费,具体许可条款与发布时间需以官方后续说明为准。
项目速览
| 类型/定位 | 开放权重的印度语言语音合成模型 |
|---|---|
| 适用设备 | 官方未公布,开放权重通常可本地部署 |
| 费用说明 | 创作者称将完全免费,细节待官方确认 |
| 语言支持 | 宣称覆盖印度 22 种官方语言 |
| 核心亮点 | 针对印度语音系优化,非英语优先训练 |
| 使用门槛 | 暂无公开版本,需等待发布或自行部署 |
| 分类 | AI 与新模型 |
| 作者 / 发布方 | Dheemanth Reddy |
| 热度 | 🔥 热度 30万 |
| 最后更新 |
Maya-2 是谁做的,它想解决什么问题
Maya-2 由开发者 Dheemanth Reddy 于 2026 年 10 月 14 日公布,定位是一个面向印度语言的开放权重语音合成模型。创作者在公布中强调,印度拥有超过 15 亿人口和 22 种官方语言,因此面向印度的 AI 未来应当是语音优先的,而不是把英语能力简单翻译过来。这个判断抓住了印度市场的真实痛点:大量用户更习惯用母语说话,而不是打字。
从公开信息看,Maya-2 的目标是把文字转成自然的印度语言语音,并且把权重完全开放,允许下载和本地部署。这与许多只提供云端接口的商业语音服务形成对比。创作者还表示,它将在不久后对所有开发者完全免费,不过具体的许可条款、商用限制和发布时间都还没有正式文件说明。
需要明确的是,目前没有公开构建版本、下载渠道或官方页面,外界能看到的只有一段简短的预告展示。因此现在讨论它的实际音质、延迟和稳定性都为时过早。读者如果关心进展,应当以官方后续发布的说明为准,而不是依据预告中的演示片段下结论。
- 发布者与时间
由 Dheemanth Reddy 于 2026 年 10 月 14 日公布,属于个人或小团队主导的开放权重项目。
- 目标人群
面向印度语言开发者和需要母语语音体验的产品团队,而非英语优先的通用场景。
- 开放权重意味着什么
权重开放通常意味着可以下载到本地运行、自行微调,但具体许可仍要看官方条款。
核心能力:22 种官方语言与针对印度语音系的调优
按照创作者的说法,Maya-2 覆盖印度 22 种官方语言,并且架构是针对印度语音系专门调优的,而不是在英语优先的数据上训练后再做适配。这一点很关键,因为印度语言的发音、重音和韵律与英语差异很大,直接套用英语模型往往会出现语调生硬、连读错误的问题。
创作者还声称,Maya-2 在多项印度语言评测中超过了 ElevenLabs v3、Cartesia Sonic 3.5 和 Bulbul v3。这些名字分别代表国际商业语音服务和面向印度市场的语音模型,属于同类产品中的常见参照对象。不过这些对比目前只有创作者一方的说法,没有公开的评测方法、测试集或第三方复现,读者应当把它当作待验证的宣称。
从产品形态看,Maya-2 属于文字转语音模型,输入文本、输出语音。它并不等同于语音识别或语音对话模型,因此不要期待它能听懂你说的话。如果你需要的是完整的语音交互链路,通常还需要搭配识别模型和对话模型一起使用。
- 语言覆盖
宣称覆盖印度 22 种官方语言,但每种语言的实际质量是否均衡,官方尚未给出细节。
- 音系优化
针对印度语音的发音与韵律设计,理论上比英语优先模型更自然,但需要实测验证。
- 对比对象
自称超过 ElevenLabs v3、Cartesia Sonic 3.5 与 Bulbul v3,属于创作者单方面宣称。
- 模型类型
属于文字转语音,不含语音识别能力,做完整语音助手还需搭配其他模型。
现在能怎么用:从等待发布到提前准备
由于目前没有公开构建版本或官方页面,最现实的做法是先把注意力放在准备工作上,而不是急着寻找下载链接。你可以先整理自己业务中最常用的印度语言短句,作为将来测试用的样本集,这样一旦模型发布,就能第一时间判断它是否适合自己的场景。
等模型正式开放后,开放权重项目通常有两条使用路径:一是下载权重在本地或自有服务器上部署,适合对数据隐私和成本敏感、又有一定工程能力的团队;二是等待社区或第三方封装出更易用的接口和工具。具体支持哪种方式,需要看官方公布的许可和文件说明。
在真正投入生产之前,建议先用自己母语的短句做小规模对比测试,把 Maya-2 的输出与你现在使用的商业语音服务放在一起听。重点听发音准确度、语调自然度和长句的稳定性,而不是只看演示片段。只有在自己的语料上表现稳定,才值得考虑替换现有方案。
- 先建测试集
提前准备常用印度语言短句和长句样本,发布后可直接用于横向对比。
- 关注许可条款
开放权重不等于无条件商用,发布后要确认许可范围、署名要求和商用限制。
- 小规模验证再上线
先用少量真实语料测试音质与稳定性,确认无误后再考虑接入生产环境。
和同类产品比,它适合谁、又有哪些不确定
与 ElevenLabs 这类国际商业语音服务相比,Maya-2 最大的差异在于开放权重和印度语言专精。商业服务通常提供成熟的云端接口、稳定的延迟和丰富的音色库,但按量计费,且数据要经过对方服务器。Maya-2 如果真如宣称那样免费开放权重,对预算有限、又需要本地部署的印度语言项目会很有吸引力。
与 Bulbul 这类同样面向印度语言的模型相比,竞争点在于语言覆盖广度和音质。覆盖 22 种官方语言听起来很全面,但实际每种语言的数据量和自然度可能差别很大,小语种的表现尤其需要实测。创作者声称的评测优势目前缺乏第三方验证,这是判断时最大的不确定因素。
总体而言,Maya-2 更适合有工程能力、关注数据主权、并且主要服务印度语言用户的开发者。如果你只需要英语语音,或者希望开箱即用、不想自己部署,那么成熟的商业服务可能仍是更省心的选择。在官方发布正式版本和许可条款之前,建议保持关注但不要把它写进生产计划。
- 对比商业服务
商业服务胜在稳定接口和音色丰富,Maya-2 胜在开放权重和印度语言专精。
- 对比同类印度模型
语言覆盖更广是卖点,但小语种实际质量与音质仍需实测验证。
- 主要不确定
评测优势无第三方复现,发布时间、许可条款和部署方式均未公布。
分步上手指南
确认当前状态,不要寻找不存在的下载
Maya-2 目前只有预告展示,没有公开构建版本或官方页面。先关注创作者后续的正式发布说明,避免下载来路不明的所谓权重文件。
整理自己的印度语言测试语料
挑选你业务中最常见的短句、数字、人名和长句,覆盖你真正需要的几种语言。这份语料将来可以直接用于对比 Maya-2 与你现有语音服务的输出。
发布后先跑小规模对比测试
拿到可用版本后,用同一批文本分别生成 Maya-2 和现有服务的语音,重点听发音准确度、语调自然度和长句稳定性。不要只依赖官方演示片段做判断。
核对许可与部署要求
开放权重项目通常附带许可条款,需确认是否允许商用、是否要求署名、能否修改后再分发。同时确认硬件要求,判断本地部署是否在你的预算之内。
通过验证后再接入生产
只有在自己的语料上表现稳定、许可也满足要求时,才考虑把它接入正式产品。建议先在小流量场景灰度上线,观察延迟和稳定性再逐步扩大使用范围。
常见问题
Maya-2 现在可以下载或使用吗?
目前还不能。根据公开信息,Maya-2 没有发布公开构建版本、下载渠道或官方页面,创作者只展示了一段简短的预告。想要使用它,需要等待官方正式发布权重和说明文件。在那之前,任何声称提供 Maya-2 下载的渠道都应当谨慎对待。
Maya-2 真的免费吗?
创作者表示它将很快对所有开发者完全免费,但截至目前没有正式的许可条款或定价页面公布。开放权重项目有时免费提供权重,但对商用或大规模部署设有条件。建议在发布后仔细阅读官方许可说明,确认自己的使用场景是否被允许。
它支持哪些语言,中文能用吗?
官方说法是覆盖印度 22 种官方语言,定位是印度语言语音合成,并没有提到中文或其他非印度语言的支持。由于架构针对印度语音系调优,即便技术上能处理其他语言,效果也未必理想。如果你的需求是中文语音,应当寻找专门面向中文的模型。
它和 ElevenLabs 相比哪个更好?
创作者声称 Maya-2 在多项印度语言评测中超过 ElevenLabs v3、Cartesia Sonic 3.5 和 Bulbul v3,但这些对比目前没有公开的评测方法或第三方复现。ElevenLabs 的优势在于成熟的云端接口、稳定性和丰富音色,Maya-2 的潜在优势是开放权重和印度语言专精。最终哪个更合适,取决于你的语言需求、预算和部署能力。
开放权重是什么意思,对我有什么影响?
开放权重通常指模型参数可以下载,允许在本地或自有服务器上运行,甚至可能允许微调。对开发者来说,这意味着更好的数据隐私控制和潜在的长期成本优势,但也需要自己承担部署、硬件和维护工作。具体权利范围仍要以官方许可条款为准。





