核心要点速览
- Pi API 是 Physical Intelligence 推出的公测平台,用于把其通用机器人基础模型适配到具体机器与任务上。
- 使用方式是上传自家机器人的任务演示数据,通过托管流水线微调 Pi 模型,再在官方基础设施上运行推理。
- 官方称已与多个行业团队合作,覆盖从采摘草莓到组装服务器等不同场景,现在向更多团队开放访问。
- 目前没有该产品的独立页面,申请入口与最新状态需以官方站点 physicalintelligence.company 为准。
项目速览
| 类型/定位 | 机器人基础模型微调与托管推理 API(公测) |
|---|---|
| 适用设备 | 各类机器人本体,取决于团队自有硬件 |
| 费用说明 | 官方未公布定价,需在官方站点确认 |
| 语言支持 | 面向开发者的接口,文档语言以官方为准 |
| 核心亮点 | 上传数据即可微调,训练与部署由平台托管 |
| 使用门槛 | 需有机器人数据与工程能力,并申请公测 |
| 分类 | AI 与新模型 |
| 作者 / 发布方 | Physical Intelligence |
| 官方网站 | physicalintelligence.company ↗ |
| 热度 | 🔥 热度 41万 |
| 最后更新 |
Pi 机器人模型接口的来龙去脉:谁做的、解决什么问题
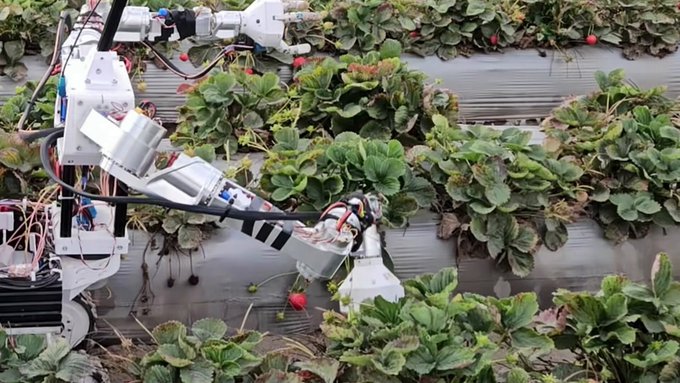
Pi 机器人模型接口(Pi API)来自机器人基础模型公司 Physical Intelligence,于 2026 年 10 月 13 日宣布进入公测。它的核心思路不是让每个团队自己训练一个机器人模型,而是提供已经具备通用操作能力的 π 系列模型,让开发者用自家机器人的数据把它“调”成适合特定机器和任务的版本。官方在公告中提到,他们此前已与不同行业的公司合作,把模型适配到各自的机器人与应用上,场景从采摘草莓一直到组装服务器。
机器人行业长期存在一个结构性难题:每家公司的硬件形态、传感器配置、末端执行器和任务流程都不一样,通用模型很难直接落地,而自建机器学习团队又贵又慢。Pi API 试图把这段工作标准化——数据由你提供,训练流水线和推理算力由平台承担。对中小型机器人团队来说,这意味着不必从零搭建训练框架、分布式算力和部署管线,可以把精力放在数据采集和任务设计上。
需要注意的是,目前官方还没有为这个产品开设独立页面,公测的申请方式、支持范围与后续更新都以 Physical Intelligence 的官方站点 physicalintelligence.company 为准。也就是说,它已经真实开放,但很多细节仍在滚动公布中,读者在动手前应先到官方站点核对最新说明。
- 定位是平台而非单一模型
Pi API 提供的是“基础模型加微调流水线加托管推理”的组合,而不是一个固定能力的成品机器人。
- 官方强调跨行业适配
公告点名的场景包括农业采摘与服务器组装,说明目标不是单一产线,而是多种操作类任务。
- 公测意味着能力仍在演进
处于 beta 阶段的产品,接口、配额与支持的任务类型都可能调整,需持续关注官方说明。
它是怎么工作的:数据上传、微调与托管推理三步走
从公开信息看,Pi API 的工作流可以概括为三步。第一步是数据准备:团队采集自家机器人在目标任务上的演示数据,例如抓取、放置、插接等动作的观测与执行记录。第二步是微调:把数据上传后,通过平台托管的训练流水线,在一个 Pi 基础模型上做适配训练,让模型学会这台机器、这套传感器和这个任务的特点。第三步是推理:训练好的模型运行在 Physical Intelligence 的基础设施上,机器人通过接口调用获得动作输出。
这种“托管式微调”与常见的开源机器人模型自部署路线形成对比。自部署路线自由度高,但团队要自己处理数据格式、训练脚本、算力调度和推理服务;托管路线把这些环节收进平台,代价是对平台接口和算力供给的依赖更强。对没有大规模机器学习工程团队的机器人公司,托管往往更快见效;对数据高度敏感或有特殊合规要求的团队,则要评估把数据交给外部平台是否可接受。
关于模型架构、参数量、支持的动作空间维度、推理延迟与并发配额等具体技术参数,官方公告并未给出,本文也无法确认。这些细节通常会在正式文档或申请通过后提供。如果你的项目对延迟或部署形态有硬性要求,建议在申请公测时直接向官方确认,而不是依据推测做技术选型。
- 数据质量比数量更关键
微调效果高度依赖演示数据是否干净、动作是否一致,先做小规模高质量数据集通常比堆量更划算。
- 训练与推理都在云端
平台承担训练流水线与推理算力,团队无需自建 GPU 集群,但要考虑网络与数据合规问题。
- 接口细节以官方文档为准
调用方式、数据格式与配额尚未公开,动手前应先在官方站点确认最新文档。
从零上手:申请公测到跑通第一个任务的实操路径
如果你手上已经有一台可编程机器人,最稳妥的起步方式是先做一个范围极小的任务,例如把物体从 A 点搬到 B 点。围绕这个任务采集几十到上百条演示数据,保持光照、物体位置和操作方式尽量一致,这样微调出来的模型更容易判断成败。数据采集阶段就要想清楚评估标准:怎样算成功、允许多大误差、失败时如何记录,这些会直接决定你能否判断微调是否有效。
接下来是申请公测与微调。由于官方目前没有独立产品页面,申请入口和所需材料需要到 physicalintelligence.company 查询。通过后,按平台要求整理并上传数据,选择一个 Pi 基础模型开始微调。第一次训练建议只跑小规模实验,先确认数据能被正确读取、训练能正常收敛,再考虑扩大数据量和任务复杂度。
最后是部署与迭代。模型在官方基础设施上运行推理,你的机器人程序通过接口获取动作输出。上线后要建立持续采集机制:把真实运行中的失败案例收集起来,补进下一轮微调数据。机器人任务很少一次调好,通常需要几轮“采集—微调—评估—补数据”的循环,才能把成功率稳定在可接受水平。
需要提醒的是,公测阶段的支持范围、可用区域和资源配额都可能变化,任何关于价格、延迟或支持硬件的承诺都应以官方最新说明为准。不要基于本文或第三方转述做采购决策。
- 先窄后宽
从一个固定工位、固定物体的简单任务开始,跑通全流程后再扩展到多物体、多位置。
- 评估标准前置
在采集数据前定义成功率和容错范围,否则微调后无法判断模型是否真的变好。
- 保留失败样本
真实运行中的失败案例是最有价值的补充数据,建立记录机制能让下一轮微调更有针对性。
适用场景、同类对比与现阶段局限
从官方描述看,Pi API 适合那些已有机器人硬件、有明确操作任务、但缺乏自建机器学习能力的团队。典型场景包括农业采摘、装配与物料搬运、实验室自动化等重复性操作任务。它的价值在于把“通用模型加少量专用数据”这条路走通,让团队用相对小的数据量获得可用的专用策略,而不是为每个任务重写传统运动规划程序。
与同类路线相比,它的差异主要在托管程度。开源机器人基础模型允许团队完全自部署,灵活但工程负担重;大厂自研的机器人模型通常不对外开放;而 Pi API 走的是中间路线——模型能力由平台提供,适配数据由客户提供,训练与推理由平台托管。这种模式在软件领域已被验证可行,但在机器人领域仍属较新的尝试,长期能否覆盖足够多样的硬件形态,是它面临的核心考验。
现阶段的局限也很明确。第一,官方尚未公布定价、配额、支持硬件清单与性能指标,选型依据不足。第二,没有独立产品页面,文档与申请流程的成熟度有待观察。第三,把机器人运行数据上传到外部平台,对部分企业存在数据与合规顾虑。第四,托管推理意味着对网络和平台可用性的依赖,对延迟极敏感的任务需要谨慎评估。是否适合你的项目,取决于任务复杂度、数据敏感度和团队工程能力三者的平衡。
- 适合谁
有机器人硬件和任务数据、希望快速获得专用策略、但不想自建训练与推理栈的团队。
- 不适合谁
对数据外传有严格限制、或对推理延迟与离线运行有硬性要求的场景,需先评估替代方案。
- 对比自部署开源模型
自部署自由度高但工程成本大;Pi API 省去基础设施工作,代价是依赖平台接口与算力供给。
- 待确认事项
定价、配额、支持硬件与性能数据均未公开,务必以官方站点最新信息为准。
分步上手指南
确认需求与硬件条件
先明确你要解决的具体操作任务,并确认机器人具备可编程接口与数据采集能力。任务越具体,后续数据采集和评估越容易设计。
采集小规模高质量演示数据
围绕单一任务录制几十到上百条演示,保持环境与操作方式一致,并同步记录成功与失败。数据干净程度往往比数量更影响微调结果。
到官方站点申请公测
目前没有独立产品页面,需前往 Physical Intelligence 官方站点 physicalintelligence.company 查询申请方式与所需材料。通过后再按平台要求整理并上传数据。
微调基础模型并做小规模验证
选择一个 Pi 基础模型启动微调,先跑小实验确认数据读取与训练正常,再在真实机器人上做有限场景测试,记录成功率与失败模式。
部署推理并持续迭代
模型在官方基础设施上运行推理,机器人程序通过接口调用。上线后持续收集失败案例,补进下一轮微调数据,逐步扩大任务范围。
常见问题
Pi API 是什么?和普通机器人编程有什么区别?
Pi API 是 Physical Intelligence 推出的公测平台,让开发者用自家机器人的数据微调其通用机器人基础模型,并在官方基础设施上运行推理。与传统逐条编写运动规划不同,它走的是“数据驱动”的路线:你提供演示数据,模型学习任务策略。官方称已与多个行业团队合作,覆盖采摘草莓到组装服务器等场景。
怎么申请 Pi API 公测?有官网入口吗?
目前官方还没有为这个产品开设独立页面,申请入口与最新状态需要到 Physical Intelligence 的官方站点 physicalintelligence.company 查询。建议先在官方站点确认公测范围、所需材料与支持的任务类型,再准备数据。不要依据第三方转述提交敏感信息。
使用 Pi API 需要多少费用?
官方尚未公布定价信息,公测阶段的收费方式、配额与是否免费都不明确。任何具体价格说法都应视为未经证实。建议在申请时直接向官方确认计费方式,并根据自身数据量和推理调用频率评估成本。
需要什么样的数据才能微调?数据量要多大?
从公开信息看,需要采集自家机器人在目标任务上的演示数据,包括观测与执行记录。官方未公布具体数据量要求,实践中通常建议先做小规模、高质量、动作一致的数据集,跑通流程后再逐步扩量。数据质量与一致性往往比单纯堆量更重要。
它支持哪些机器人硬件?推理延迟怎么样?
官方公告没有列出支持的硬件清单,也没有公布推理延迟、并发配额等性能指标。由于推理运行在官方基础设施上,实际表现会受网络与平台供给影响。如果你的任务对延迟或离线运行有硬性要求,建议在申请公测时直接向官方确认,再决定是否采用。





