Das Wichtigste in Kürze
- Bonsai 2 ist eine Modellfamilie von PrismML in den Größen 2B, 4B und 9B, die auf Qwen3.5 basiert und unter Apache 2.0 stehen soll.
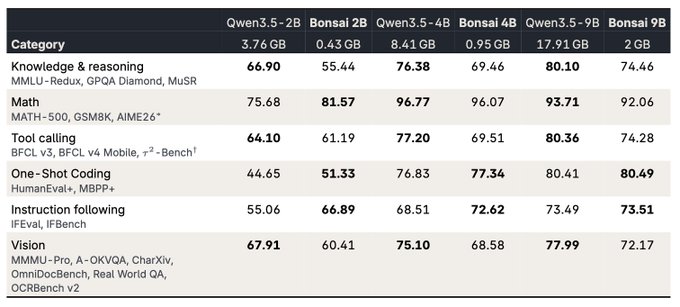
- Durch ternäre Gewichte sinken die Speichergrößen auf rund 0,43 GB (2B), 0,95 GB (4B) und 2,0 GB (9B), was lokale Nutzung auf Handys und Macs ermöglichen soll.
- Die Modelle zielen auf Anweisungstreue, weniger Wiederholungsschleifen, Tool-Aufrufe auf Mobilgeräten und visuelles Verständnis; das 9B-Modell soll rund 40 Prozent weniger Tokens verbrauchen.
- Einen öffentlichen Build, Download oder eine offizielle Seite gibt es noch nicht; bis dahin lohnt sich das Verfolgen der PrismML-Ankündigungen und das Testen vergleichbarer kleiner Modelle.
Kurzüberblick
| Typ | Offene Ternär-Sprachmodelle mit Vision und Tool-Calling |
|---|---|
| Geräte | Handys, Macs, Wearables (laut Ankündigung) |
| Kosten | Noch unbekannt; Apache 2.0 angekündigt |
| Sprachen | Nicht bestätigt; Qwen3.5-Basis legt Mehrsprachigkeit nahe |
| Highlight | 9B-Klasse in rund 2 GB Speichergröße |
| Einstieg | Noch kein Download; nur Ankündigung und Vorschau |
| Kategorie | KI & Modelle |
| Urheber | PrismML |
| Trend-Index | 🔥 324,8 Tsd. Trend-Index |
| Zuletzt aktualisiert |
Was Bonsai 2 ist und warum gerade darüber gesprochen wird
Bonsai 2 ist eine Familie kompakter KI-Modelle des Unternehmens PrismML, die am 15. Oktober 2026 angekündigt wurde. Sie umfasst zunächst die Größen 2B, 4B und 9B Parameter und baut laut Ankündigung auf Qwen3.5 auf. Damit tritt sie die Nachfolge der ersten Bonsai-Generation mit 1,7B, 4B und 8B an. Die Familie soll perspektivisch vier Größen von 2B bis 27B abdecken.
Das Besondere ist der ternäre Ansatz: Statt der üblichen Gleitkommazahlen nutzen die Gewichte offenbar nur drei Zustände. Dadurch schrumpfen die Modelldateien drastisch, auf rund 0,43 GB beim 2B-, 0,95 GB beim 4B- und 2,0 GB beim 9B-Modell. Genau diese Kombination aus kleiner Dateigröße und vergleichsweise hoher Parameterzahl macht die Ankündigung derzeit so interessant für alle, die KI lokal betreiben wollen.
PrismML positioniert die Modelle ausdrücklich als Grundlage für praktische Agentenfunktionen auf persönlichen Geräten. Genannt werden Computer, Smartphones und Wearables. Die Lizenz soll Apache 2.0 sein, was kommerzielle und private Nutzung erlauben würde. Wichtig: Bislang existiert nur die Ankündigung samt kurzer Vorschau, kein öffentlicher Build und keine offizielle Produktseite.
- Ternär statt 4-Bit
Ternäre Gewichte sind noch extremer als gängige 4-Bit-Quantisierung und erklären die ungewöhnlich kleinen Dateigrößen der drei Varianten.
- Basis Qwen3.5
Die Modelle nutzen eine bestehende Qwen3.5-Architektur als Grundlage, was auf ausgereifte Mehrsprachigkeit und Werkzeugnutzung hindeutet.
- Vier Größen geplant
Angekündigt sind 2B, 4B und 9B, die Familie soll aber bis 27B Parameter reichen.
- Apache 2.0
Die offene Lizenz würde lokale und kommerzielle Nutzung ohne Sondervereinbarung ermöglichen, sofern sie beim Release bestätigt wird.
Ternäre Gewichte, Tool-Calling und Vision: die Technik im Detail
Ternäre Modelle speichern Gewichte in drei Stufen, meist als negative, neutrale und positive Werte. Das senkt den Speicherbedarf und die Rechenlast erheblich, weil Multiplikationen stark vereinfacht werden können. Der Preis dafür ist ein möglicher Genauigkeitsverlust, den PrismML offenbar durch Training und Architekturwahl ausgleichen will. Wie gut das gelingt, lässt sich ohne veröffentlichte Gewichte oder Benchmarks noch nicht beurteilen.
Laut Ankündigung liegt der Fokus auf vier Dingen: Anweisungen befolgen, Wiederholungsschleifen vermeiden, Werkzeuge auf Mobilgeräten aufrufen und nützliche Antworten ohne unnötig lange Ausgaben liefern. Das 9B-Modell soll bei typischen Anweisungs- und Alltagsmathe-Aufgaben rund 40 Prozent weniger Tokens verbrauchen. Das ist vor allem für lokale Assistenten relevant, weil kürzere Ausgaben Strom, Zeit und Kontextfenster sparen.
Neben Text sollen die Modelle auch visuelles Verständnis mitbringen, also Bilder beschreiben oder auswerten können. Zusammen mit Tool-Calling ergibt das ein Profil, das eher auf kleine Agenten als auf reine Chatbots zielt: Ein Assistent auf dem Handy könnte etwa Kalender, Kamera oder lokale Dateien ansprechen. Ob und wie stark diese Fähigkeiten in jeder Größe vorhanden sind, ist nicht bestätigt und dürfte erst mit dem Release klar werden.
- Speicherbedarf
0,43 GB, 0,95 GB und 2,0 GB sind für 2B-, 4B- und 9B-Modelle außergewöhnlich klein und passen selbst auf einfache Smartphones.
- Weniger Tokens
Rund 40 Prozent weniger Token-Verbrauch beim 9B-Modell würde Antworten beschleunigen und Akku schonen.
- Werkzeuge auf Mobilgeräten
Tool-Calling direkt auf dem Handy ist der Kern des Agenten-Versprechens, nicht nur Chat im Browser.
- Offene Fragen
Kontextlänge, Trainingsdaten, Benchmarkwerte und genaue Lizenzbedingungen sind bislang nicht öffentlich bestätigt.
So würdest du Bonsai 2 lokal nutzen, sobald es verfügbar ist
Da es noch keinen Download gibt, lässt sich der Ablauf nur aus der Ankündigung ableiten. PrismML nennt Handys, Macs und Wearables als Zielplattformen und beschreibt die Modelle als Grundlage für lokale Anwendungen. Wer heute schon lokal mit KI arbeitet, kennt den typischen Weg: Modell herunterladen, in eine Laufzeitumgebung wie llama.cpp oder eine App mit GGUF-Unterstützung laden und dort chatten oder Werkzeuge anbinden.
Für den Einstieg empfiehlt sich die kleinste Variante. Das 2B-Modell mit rund 0,43 GB lädt schnell und zeigt, ob Geschwindigkeit und Antwortqualität auf dem eigenen Gerät ausreichen. Reicht die Qualität nicht, ist das 4B-Modell mit 0,95 GB der nächste Schritt. Erst wenn du stärkeres Schlussfolgern oder Bildverständnis brauchst, lohnt das 9B-Modell mit 2,0 GB, das eher auf einem Mac oder einem leistungsfähigen Telefon sinnvoll läuft.
Wichtig ist realistische Erwartungshaltung: Ein 9B-Modell in 2 GB wird bei komplexen Aufgaben nicht mit großen Cloud-Modellen mithalten. Der Vorteil liegt bei Datenschutz, Offline-Betrieb und niedriger Latenz. Prüfe nach dem Release auf der offiziellen Seite von PrismML, welche Laufzeiten, Formate und Lizenzdetails tatsächlich genannt werden, bevor du Bonsai 2 in eigene Projekte einbaust.
- Klein anfangen
Teste zuerst das 2B-Modell auf deinem Telefon, um Ladezeit und Antworttempo zu prüfen.
- Dann skalieren
Wechsle zu 4B oder 9B, wenn dir Schlussfolgerungen oder Bildverständnis zu schwach sind.
- Offline testen
Prüfe im Flugmodus, ob Chat und Werkzeuge wirklich ohne Netz funktionieren.
- Lizenz lesen
Kläre vor kommerziellem Einsatz die endgültigen Apache-2.0-Bedingungen auf der offiziellen Seite.
Vergleich mit ähnlichen Modellen und für wen sich Bonsai 2 lohnt
Der Vergleich liegt nahe mit anderen kleinen offenen Modellen wie Qwen3.5 in kleinen Varianten, Gemma oder Phi. Deren Stärke ist meist die breite Werkzeugunterstützung und gute Dokumentation, ihr Nachteil der höhere Speicherbedarf. Bonsai 2 setzt dagegen auf extreme Kompression durch ternäre Gewichte und verspricht dadurch 9B-Qualität in einem 2-GB-Paket. Ob dieses Versprechen hält, muss sich in unabhängigen Tests zeigen.
Ein zweiter Vergleichspunkt sind Cloud-Dienste. Sie sind heute bei komplexen Aufgaben klar überlegen, kosten aber pro Nutzung, brauchen Internet und verarbeiten Daten auf fremden Servern. Bonsai 2 zielt auf das Gegenteil: private, günstige, jederzeit verfügbare Assistenten auf eigenen Geräten. Für einfache Aufgaben wie Zusammenfassen, Umformulieren, Übersetzen oder schnelle Bildbeschreibungen kann das völlig ausreichen.
Geeignet ist Bonsai 2 damit vor allem für Entwickler, Datenschutzbewusste und Bastler, die KI in Apps, Wearables oder Offline-Szenarien einbetten wollen. Weniger geeignet ist es für Aufgaben, die maximale Schlussfolgerungsfähigkeit oder sehr langes Kontextverständnis verlangen. Solange keine Gewichte und keine offizielle Seite existieren, bleibt die Familie ein spannendes Versprechen, kein nutzbares Produkt.
- Gegenüber Cloud-KI
Bonsai 2 bietet Offline-Betrieb und Datenschutz, verliert aber bei komplexen Aufgaben gegen große Servermodelle.
- Gegenüber anderen kleinen Modellen
Der Vorteil ist die Dateigröße, der mögliche Nachteil eine geringere Genauigkeit durch ternäre Gewichte.
- Für Wearables
Kaum ein anderes Modell dieser Klasse zielt so explizit auf Uhren und andere kleine Geräte.
- Noch nicht verfügbar
Ohne Release bleibt jeder Vergleich vorläufig; verlass dich auf Tests, sobald Gewichte erscheinen.
Schritt-für-Schritt-Anleitung
Ankündigung und offizielle Seite verfolgen
Bonsai 2 wurde bislang nur angekündigt, es gibt keinen Download. Beobachte die offizielle Seite von PrismML, um Release, Lizenz und Modellformate nicht zu verpassen. Trage dich dort in eine Warteliste oder einen Newsletter ein, falls angeboten.
Passende Laufzeitumgebung vorbereiten
Lokale Modelle laufen meist über llama.cpp, Ollama oder Apps mit GGUF-Unterstützung. Installiere eine solche Umgebung auf deinem Mac oder Telefon schon jetzt und teste sie mit einem anderen kleinen Modell. So weißt du vor dem Release, ob deine Hardware mitspielt.
Mit der 2B-Variante starten
Sobald die Gewichte verfügbar sind, lade zuerst das 2B-Modell mit rund 0,43 GB. Prüfe Ladezeit, Antworttempo und Speicherverbrauch im Alltag. So erkennst du schnell, ob die kleine Variante für deine typischen Aufgaben reicht.
Auf 4B oder 9B aufsteigen
Wenn Antworten zu oberflächlich sind oder Bildverständnis fehlt, wechsle zum 4B- oder 9B-Modell. Achte auf genügend Arbeitsspeicher und teste im Flugmodus, ob alles offline läuft. Vergleiche Token-Ausgaben und Antwortqualität mit der kleinen Variante.
Werkzeuge anbinden und Grenzen prüfen
Richte Tool-Calling für Kalender, Dateien oder Kamera ein, falls die Laufzeit das unterstützt. Teste bewusst Aufgaben, die das Modell überfordern, um die Grenzen zu kennen. Für kritische Anwendungen solltest du Antworten weiterhin prüfen.
Häufige Fragen
Was genau ist Bonsai 2 und wer steckt dahinter?
Bonsai 2 ist eine Familie kompakter KI-Modelle des Unternehmens PrismML, angekündigt am 15. Oktober 2026. Sie umfasst die Größen 2B, 4B und 9B Parameter, basiert laut Ankündigung auf Qwen3.5 und soll unter Apache 2.0 stehen. Die Familie soll später bis 27B Parameter reichen und die erste Bonsai-Generation ablösen.
Kann ich Bonsai 2 schon herunterladen oder ausprobieren?
Nein, bislang gibt es weder einen öffentlichen Build noch einen Download oder eine offizielle Produktseite. PrismML hat die Modelle nur in einer kurzen Vorschau und Ankündigung gezeigt. Du kannst derzeit nur die offizielle Seite beobachten und mit anderen kleinen Modellen üben, bis ein Release erscheint.
Was bedeutet ternär und warum sind die Modelle so klein?
Ternäre Gewichte nutzen nur drei Zustände statt feiner Gleitkommazahlen, wodurch Speicher und Rechenaufwand stark sinken. Deshalb wiegt das 2B-Modell nur rund 0,43 GB, das 4B-Modell 0,95 GB und das 9B-Modell 2,0 GB. Der mögliche Nachteil ist eine geringere Genauigkeit, die erst unabhängige Tests nach dem Release zeigen werden.
Auf welchen Geräten läuft Bonsai 2 und was kostet es?
PrismML nennt Handys, Macs und Wearables als Zielplattformen. Konkrete Systemanforderungen, unterstützte Laufzeiten und Preise sind noch nicht bestätigt. Die angekündigte Apache-2.0-Lizenz würde eine kostenlose Nutzung nahelegen, doch verbindlich ist das erst mit der offiziellen Veröffentlichung. Prüfe die Angaben dann auf der offiziellen Seite.
Für welche Aufgaben lohnt sich Bonsai 2 und wo liegen die Grenzen?
Sinnvoll sind lokale Assistenten für Zusammenfassen, Umformulieren, Übersetzen, einfache Mathe und Bildbeschreibungen, besonders offline und datenschutzfreundlich. Bei komplexem Schlussfolgern oder sehr langem Kontext werden große Cloud-Modelle überlegen bleiben. Das 9B-Modell soll bei Alltagsaufgaben rund 40 Prozent weniger Tokens verbrauchen, was Latenz und Akkulaufzeit verbessert.