Puntos clave
- Bonsai 2 es una familia de modelos de lenguaje ternarios de 2B, 4B y 9B parámetros desarrollada por PrismML y basada en Qwen3.5, con licencia Apache 2.0.
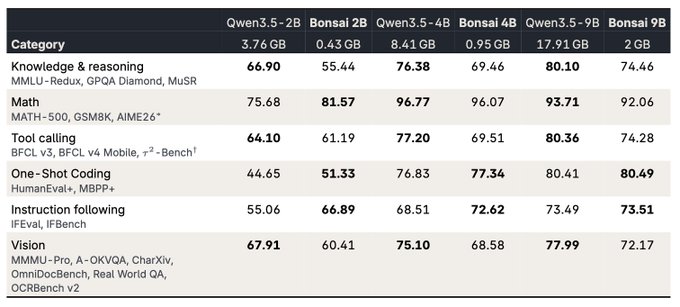
- Sus pesos ternarios reducen el tamaño a 0,43 GB, 0,95 GB y 2,0 GB, lo que permite ejecutarlos localmente en teléfonos, Macs y wearables sin conexión.
- El modelo de 9B usa aproximadamente un 40 % menos de tokens en tareas estándar de instrucciones y matemáticas cotidianas, según la empresa.
- Todavía no hay compilación pública ni página oficial de descarga; por ahora solo se ha mostrado en un anuncio y un vídeo de vista previa.
Datos rápidos
| Tipo | Modelos de lenguaje ternarios compactos |
|---|---|
| Dispositivos | Teléfonos, Macs y wearables (inferencia local) |
| Precio | Gratis con licencia Apache 2.0 (previsto) |
| Idiomas | No confirmados; consulta la web oficial |
| Lo destacado | 9B en solo 2,0 GB con visión y tool calling |
| Dificultad | Media: requiere conocimientos técnicos básicos |
| Categoría | IA y modelos |
| Creador | PrismML |
| Popularidad | 🔥 324,8K Popularidad |
| Última actualización |
Qué es Bonsai 2 y por qué está en tendencia
Bonsai 2 es una familia de modelos de inteligencia artificial compactos y ternarios presentada por PrismML el 15 de octubre de 2026. Incluye versiones de 2B, 4B y 9B parámetros, construidas sobre Qwen3.5 y publicadas bajo licencia Apache 2.0, lo que en principio permite uso comercial y modificación. La familia completa abarca desde 2B hasta 27B parámetros, aunque el anuncio se centró en los tres tamaños más pequeños. Está en tendencia porque promete llevar razonamiento, visión y llamadas a herramientas a dispositivos cotidianos sin depender de la nube.
La clave de su popularidad es el uso de pesos ternarios, que solo emplean tres valores posibles en lugar de los habituales de alta precisión. Eso reduce drásticamente el espacio que ocupan: 0,43 GB para el modelo de 2B, 0,95 GB para el de 4B y 2,0 GB para el de 9B. Para hacerte una idea, un modelo convencional de 9B suele ocupar varios gigabytes, así que la diferencia es notable. PrismML afirma que estos modelos son sucesores de su primera generación Bonsai 1.7B, 4B y 8B.
El anuncio destaca que Bonsai 2 se centra en lo que hace útiles a los modelos pequeños como asistentes locales: seguir instrucciones, evitar bucles repetitivos, llamar a herramientas en móviles y dar respuestas útiles sin salidas innecesarias. El modelo de 9B, según la empresa, usa aproximadamente un 40 % menos de tokens en tareas estándar de seguimiento de instrucciones y matemáticas cotidianas. La compañía lo resumió con humor diciendo que resolver la hipótesis de Riemann puede esperar, dejando claro que su objetivo es la practicidad diaria y no los grandes desafíos científicos.
- Tamaños y pesos
2B (0,43 GB), 4B (0,95 GB) y 9B (2,0 GB). La familia completa llega hasta 27B parámetros, aunque aún no se detallaron todos los tamaños.
- Base y licencia
Construidos sobre Qwen3.5 y publicados bajo Apache 2.0, lo que facilita su integración en proyectos personales y comerciales.
- Enfoque práctico
Priorizan el uso como asistente local: instrucciones, tool calling en móviles y respuestas concisas, más que tareas de investigación avanzada.
Cómo funcionan los modelos ternarios y qué ofrecen
Los modelos ternarios son una técnica de cuantización extrema en la que cada peso de la red neuronal solo puede tomar tres valores, normalmente -1, 0 y 1. En lugar de almacenar números decimales de 16 o 32 bits, se guardan valores mínimos, lo que reduce enormemente el tamaño del archivo y el consumo de memoria. Esto permite ejecutar modelos en hardware modesto, como un teléfono o un portátil sin GPU dedicada. La contrapartida es que la precisión puede resentirse, por lo que el entrenamiento y el ajuste fino son cruciales para mantener la calidad.
Bonsai 2 incorpora tres capacidades principales en sus versiones compactas: razonamiento, comprensión visual y llamadas a herramientas. El razonamiento se refiere a la capacidad de seguir cadenas de pensamiento y resolver problemas paso a paso; la visión permite interpretar imágenes, algo poco común en modelos de este tamaño; y el tool calling habilita que el modelo invoque funciones externas, como consultar el clima o enviar un mensaje, directamente desde una app móvil. PrismML afirma que estas capacidades mejoran a medida que subes de 2B a 9B.
El modelo de 9B destaca por su eficiencia: según la empresa, usa alrededor de un 40 % menos de tokens en tareas estándar de instrucciones y matemáticas cotidianas. Menos tokens significa respuestas más rápidas y menor consumo de batería en dispositivos móviles, algo crítico cuando se ejecuta localmente. Además, PrismML menciona que ha trabajado para evitar bucles repetitivos, un problema común en modelos pequeños que tienden a repetir frases. Estas mejoras buscan que Bonsai 2 sea verdaderamente útil como asistente de bolsillo, no solo una demo técnica.
- Pesos ternarios
Cada peso solo puede ser -1, 0 o 1, lo que reduce el tamaño del modelo a una fracción de lo habitual y permite inferencia en dispositivos sin GPU potente.
- Visión integrada
Los modelos pueden procesar imágenes además de texto, algo poco frecuente en tamaños tan pequeños, según el anuncio de PrismML.
- Tool calling móvil
Diseñados para llamar a herramientas desde aplicaciones en teléfonos, lo que abre la puerta a agentes locales que interactúan con otras apps.
- Eficiencia de tokens
El 9B usa aproximadamente un 40 % menos de tokens en tareas de instrucciones y matemáticas cotidianas, lo que se traduce en respuestas más rápidas y menor consumo.
Cómo probar Bonsai 2: pasos y requisitos
Actualmente no existe una compilación pública, descarga ni página oficial de Bonsai 2. PrismML solo ha mostrado el modelo en un anuncio y un breve vídeo de vista previa, por lo que no es posible ejecutarlo todavía. Si quieres estar preparado para cuando se lance, lo primero es seguir los canales oficiales de PrismML, como su sitio web, para ver cuándo publican los pesos y las instrucciones. Mientras tanto, puedes familiarizarte con el ecosistema de modelos locales y las herramientas de inferencia que probablemente sean compatibles.
Cuando el lanzamiento se produzca, lo más probable es que los pesos estén disponibles en plataformas de modelos abiertos y que puedas ejecutarlos con herramientas como llama.cpp, Ollama o LM Studio, que ya soportan modelos cuantizados. Para el modelo de 2B, un teléfono de gama media reciente debería bastar; para el de 9B, un Mac con chip de la serie M o un PC con al menos 8 GB de RAM libre sería lo recomendable. Te conviene empezar por el 2B para probar la velocidad y luego subir al 9B si necesitas más razonamiento y visión.
El proceso típico para ejecutar un modelo local implica descargar el archivo de pesos, cargarlo en la herramienta de inferencia y ajustar parámetros como la longitud de contexto o la temperatura. Como Bonsai 2 es ternario, es posible que necesites una versión específica del runtime que soporte este tipo de cuantización; consulta la documentación oficial cuando esté disponible. Si no tienes experiencia, busca tutoriales de modelos locales en general, ya que los pasos son similares. Recuerda que, al ser Apache 2.0, podrás usarlo gratis incluso con fines comerciales, siempre que respetes los términos de la licencia.
- Sigue los canales oficiales
Visita periódicamente el sitio de PrismML para ver si han publicado los pesos, la documentación y los requisitos. No hay fecha confirmada de lanzamiento público.
- Prepara tu hardware
Para el 2B basta un móvil moderno; para el 9B, un Mac con chip M o un PC con 8 GB de RAM libre. La inferencia local no requiere conexión a internet.
- Elige una herramienta compatible
llama.cpp, Ollama o LM Studio son opciones habituales para modelos cuantizados. Verifica que soporten pesos ternarios cuando Bonsai 2 salga.
- Empieza pequeño
Prueba primero el 2B para evaluar velocidad y calidad; si necesitas más razonamiento o visión, pasa al 4B o al 9B según la capacidad de tu dispositivo.
Comparativa, limitaciones y para quién es Bonsai 2
En el panorama de modelos compactos, Bonsai 2 compite con alternativas como Qwen2.5, Llama 3.2 o Gemma 2 en sus versiones pequeñas. Su principal diferenciador es el uso de pesos ternarios, que reduce el tamaño muy por debajo de lo habitual: un 9B en 2,0 GB es excepcionalmente pequeño. Sin embargo, la cuantización ternaria puede afectar la precisión en tareas complejas, y aún no hay datos públicos de rendimiento en benchmarks independientes. PrismML afirma mejoras en razonamiento, visión y tool calling, pero habrá que verificarlo cuando el modelo sea accesible.
Otra limitación es la falta de disponibilidad: al no haber una compilación pública, no puedes probarlo hoy. Tampoco se han confirmado los idiomas soportados, aunque al estar basado en Qwen3.5 es probable que tenga un buen soporte multilingüe, incluido el español. La licencia Apache 2.0 es una ventaja frente a modelos con licencias más restrictivas, pero debes verificar los términos exactos en la página oficial cuando se publiquen. Además, el soporte para tool calling en móviles dependerá de que los desarrolladores de apps integren el modelo.
Bonsai 2 está pensado para desarrolladores y entusiastas que quieran ejecutar asistentes de IA localmente en dispositivos cotidianos, sin depender de la nube. También es interesante para quienes trabajan con wearables o aplicaciones de privacidad, donde enviar datos a servidores externos no es deseable. Si buscas un modelo para tareas de razonamiento complejo o investigación, probablemente necesites modelos más grandes. Si tu prioridad es la portabilidad, la eficiencia energética y la privacidad, Bonsai 2 es una propuesta a seguir de cerca, siempre que el lanzamiento cumpla lo prometido.
- Frente a otros modelos pequeños
Bonsai 2 destaca por su tamaño reducido gracias a los pesos ternarios, pero aún no hay benchmarks públicos que confirmen su calidad frente a Qwen2.5 o Llama 3.2.
- Licencia permisiva
Apache 2.0 permite uso comercial y modificación, algo que no todos los modelos abiertos ofrecen. Consulta los términos exactos en la web oficial.
- Limitaciones actuales
No hay descarga pública ni página oficial, y se desconoce el soporte de idiomas o la compatibilidad exacta con herramientas. La cuantización ternaria puede reducir la precisión en tareas exigentes.
- Público objetivo
Desarrolladores de apps móviles, entusiastas del IA local y proyectos que priorizan privacidad y bajo consumo. No está pensado para cargas de trabajo de altas prestaciones.
Guía paso a paso
Verifica el estado del lanzamiento
Antes de nada, comprueba si PrismML ya ha publicado los pesos de Bonsai 2 en su sitio oficial. Hasta la fecha solo existe un anuncio y un vídeo de vista previa, sin descarga ni página de producto. Si aún no está disponible, apunta la fecha del anuncio (15 de octubre de 2026) y mantente atento a novedades.
Elige el tamaño adecuado
Decide si necesitas el modelo de 2B, 4B o 9B según tu hardware y tus tareas. El 2B (0,43 GB) es ideal para probar en un teléfono; el 9B (2,0 GB) ofrece más razonamiento y visión, pero requiere un Mac o PC con más memoria. Si dudas, empieza por el 2B y escala después.
Prepara el entorno de inferencia
Instala una herramienta compatible con modelos locales, como llama.cpp, Ollama o LM Studio. Asegúrate de que soporte pesos ternarios o cuantizaciones similares; es posible que necesites una versión específica. Consulta la documentación oficial de PrismML cuando esté disponible para conocer los requisitos exactos.
Descarga y carga el modelo
Cuando los pesos estén publicados, descarga el archivo correspondiente a tu tamaño elegido. Cárgalo en la herramienta de inferencia y ajusta parámetros como la longitud de contexto o la temperatura según tus necesidades. Si encuentras errores, verifica que la versión de la herramienta sea la adecuada para modelos ternarios.
Prueba y ajusta
Haz preguntas de ejemplo, prueba el reconocimiento de imágenes y las llamadas a herramientas si tu entorno lo permite. Compara la velocidad y la calidad entre el 2B y el 9B para ver cuál se adapta mejor a tu dispositivo. Recuerda que, al ser Apache 2.0, puedes integrarlo en tus proyectos respetando la licencia.
Preguntas frecuentes
¿Qué es exactamente Bonsai 2 de PrismML?
Bonsai 2 es una familia de modelos de lenguaje ternarios y compactos creada por PrismML, con versiones de 2B, 4B y 9B parámetros. Está basada en Qwen3.5 y se distribuye bajo licencia Apache 2.0. Su objetivo es llevar razonamiento, visión y llamadas a herramientas a dispositivos locales como teléfonos, Macs y wearables, con tamaños de archivo muy reducidos: 0,43 GB, 0,95 GB y 2,0 GB respectivamente. La familia completa abarca hasta 27B parámetros.
¿Ya se puede descargar o probar Bonsai 2?
No, todavía no. PrismML presentó Bonsai 2 el 15 de octubre de 2026, pero hasta ahora solo ha mostrado un anuncio y un breve vídeo de vista previa. No existe una compilación pública, un enlace de descarga ni una página oficial de producto. Para saber cuándo estará disponible, lo mejor es seguir los canales oficiales de PrismML y consultar su sitio web periódicamente. Mientras tanto, puedes preparar tu entorno de inferencia local.
¿Cuánto costará Bonsai 2 y qué licencia tiene?
Según la información disponible, Bonsai 2 se publicará bajo licencia Apache 2.0, lo que significa que será gratuito para usar, modificar y distribuir, incluso con fines comerciales, siempre que se respeten los términos de la licencia. No se ha anunciado ningún precio ni modelo de suscripción. Al ser un modelo abierto, es probable que los pesos estén disponibles para descarga gratuita, pero conviene verificar los detalles exactos en la página oficial cuando se publique.
¿En qué dispositivos podré ejecutar Bonsai 2?
Bonsai 2 está diseñado para inferencia local en teléfonos, computadoras Mac y wearables, según el anuncio de PrismML. Los tamaños reducidos permiten que el modelo de 2B funcione en un móvil moderno, mientras que el de 9B necesitará un dispositivo con más memoria, como un Mac con chip de la serie M o un PC con al menos 8 GB de RAM libre. También podría ejecutarse en otros dispositivos compatibles con herramientas de inferencia local.
¿Cómo se compara Bonsai 2 con otros modelos pequeños como Qwen o Llama?
La principal diferencia es el uso de pesos ternarios, que reducen el tamaño del archivo mucho más que las cuantizaciones habituales: un 9B en 2,0 GB es excepcionalmente compacto. PrismML afirma mejoras en razonamiento, visión y tool calling, y una reducción del 40 % en tokens para ciertas tareas. Sin embargo, aún no hay benchmarks independientes que confirmen su rendimiento frente a Qwen2.5 o Llama 3.2. Habrá que esperar a su lanzamiento para comparar con datos reales.