Das Wichtigste in Kürze
- Mit 27,5 Millionen Dollar im Rücken: Phonic startet Sprachmodell „Phonic-1“ für Tool-Aufrufe (Unternehmen: Phonic ($27,5 Mio. Series A unter Führung von First Round Capital); Architektur: Phonic-1 natives End-to-End Speech-to-Speech-Modell).
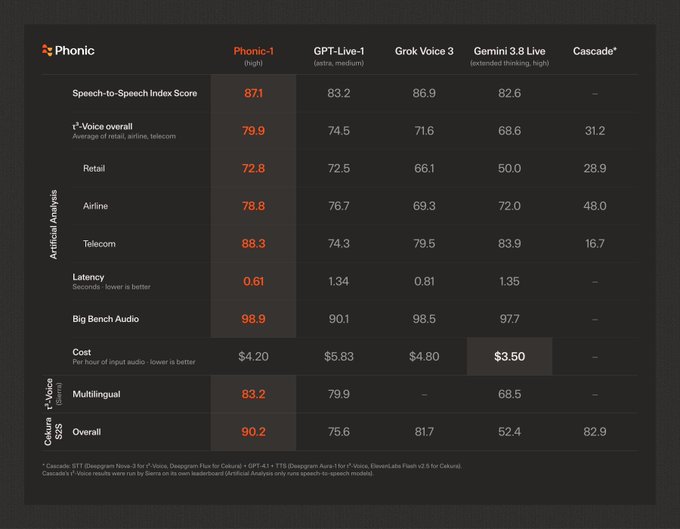
- Warum natives Speech-to-Speech mit 610 ms Latenz klassische STT-LLM-TTS-Ketten ablöst (Latenz: Ca. 610 ms Antwortzeit mit natürlicher Unterbrechungserkennung).
- Schlanke JSON-Schemata für unterbrechungsfreie Datenbankabfragen im Gespräch (Spezialgebiet: Parallele API- und Tool-Aufrufe mitten im laufenden Gespräch).
Kurzüberblick
| Unternehmen | Phonic ($27,5 Mio. Series A unter Führung von First Round Capital) |
|---|---|
| Architektur | Phonic-1 natives End-to-End Speech-to-Speech-Modell |
| Latenz | Ca. 610 ms Antwortzeit mit natürlicher Unterbrechungserkennung |
| Spezialgebiet | Parallele API- und Tool-Aufrufe mitten im laufenden Gespräch |
| Kategorie | KI & Modelle |
| Urheber | Moin Nadeem |
| Offizielle Seite | phonic.co ↗ |
| Trend-Index | 🔥 1 Mio. Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
Mit 27,5 Millionen Dollar im Rücken: Phonic startet Sprachmodell „Phonic-1“ für Tool-Aufrufe
Begleitet von einer 27,5-Millionen-Dollar-Finanzierungsrunde hat das Startup Phonic mit „Phonic-1“ ein neues Speech-to-Speech-Modell für Echtzeit-Sprachagenten vorgestellt.
Warum natives Speech-to-Speech mit 610 ms Latenz klassische STT-LLM-TTS-Ketten ablöst
Statt klassischer STT-LLM-TTS-Ketten verarbeitet Phonic-1 Audiosignale direkt mit rund 610 ms Latenz und ruft externe Werkzeuge fließend während des Gesprächs auf.
Schlanke JSON-Schemata für unterbrechungsfreie Datenbankabfragen im Gespräch
Halten Sie die JSON-Schemata für Tool-Aufrufe schlank, damit Datenbankabfragen im laufenden Gespräch ohne spürbare Pause ablaufen.
Häufige Fragen
Was sind die wichtigsten Merkmale von Phonic-1 bei Architektur, Tempo und Preis?
Unternehmen: Phonic ($27,5 Mio. Series A unter Führung von First Round Capital); Architektur: Phonic-1 natives End-to-End Speech-to-Speech-Modell; Latenz: Ca. 610 ms Antwortzeit mit natürlicher Unterbrechungserkennung. Statt klassischer STT-LLM-TTS-Ketten verarbeitet Phonic-1 Audiosignale direkt mit rund 610 ms Latenz und ruft externe Werkzeuge fließend während des Gesprächs auf.
Über welche Plattformen können Entwickler Phonic-1 testen?
Spezialgebiet: Parallele API- und Tool-Aufrufe mitten im laufenden Gespräch. Halten Sie die JSON-Schemata für Tool-Aufrufe schlank, damit Datenbankabfragen im laufenden Gespräch ohne spürbare Pause ablaufen.




