要点まとめ
- 2,750万ドル調達のPhonicが音声対音声モデル『Phonic-1』を発表、ツール実行に特化(開発企業・資金調達:Phonic(First Round主導で2,750万ドルのシリーズA調達)/アーキテクチャ:Phonic-1 エンドツーエンド音声対音声(Speech-to-Speech)モデル)。
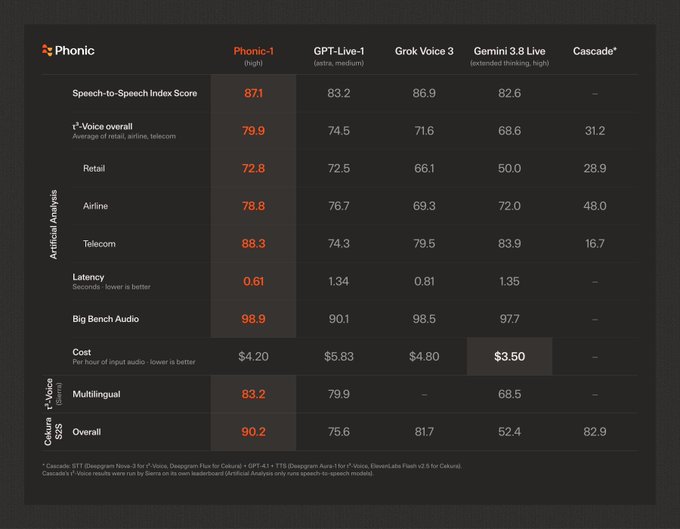
- 従来の「STT+LLM+TTS」3段構成を脱却し約0.61秒の低遅延を実現した仕組み(応答レイテンシ:約610ミリ秒(自然な相槌・割り込み制御に対応))。
- データベース照会中の待ち時間を自然な相槌で埋めるAPIスキーマ設計のコツ(最大の強み:会話を止めずにバックグラウンドで外部API・ツールを呼び出す機能)。
基本情報
| 開発企業・資金調達 | Phonic(First Round主導で2,750万ドルのシリーズA調達) |
|---|---|
| アーキテクチャ | Phonic-1 エンドツーエンド音声対音声(Speech-to-Speech)モデル |
| 応答レイテンシ | 約610ミリ秒(自然な相槌・割り込み制御に対応) |
| 最大の強み | 会話を止めずにバックグラウンドで外部API・ツールを呼び出す機能 |
| カテゴリ | AI・新モデル |
| 作者・提供元 | Moin Nadeem |
| 公式サイト | phonic.co ↗ |
| 注目度 | 🔥 注目度 107万 |
| 公開日 | |
| 最終更新 |
2,750万ドル調達のPhonicが音声対音声モデル『Phonic-1』を発表、ツール実行に特化
First Round Capital主導で2,750万ドルのシリーズA調達を発表したPhonic社は、エージェントタスク向けの最新Speech-to-Speech(音声対音声)モデル『Phonic-1』を公開しました。
従来の「STT+LLM+TTS」3段構成を脱却し約0.61秒の低遅延を実現した仕組み
従来の「音声認識+LLM+音声合成」の3段構成ではなく、音声を直接処理することで約0.61秒の低遅延と自然な相槌・割り込み応答、会話中の外部ツール実行を両立しています。
データベース照会中の待ち時間を自然な相槌で埋めるAPIスキーマ設計のコツ
ツール呼び出しを組み込む際は、APIスキーマを最小限に絞るとともに相槌ストリームを有効にすると、データベース照会中の待ち時間を自然に埋められます。
よくある質問
Phonic-1のアーキテクチャや性能・価格面の強みは何ですか?
開発企業・資金調達は「Phonic(First Round主導で2,750万ドルのシリーズA調達)」、アーキテクチャは「Phonic-1 エンドツーエンド音声対音声(Speech-to-Speech)モデル」、応答レイテンシは「約610ミリ秒(自然な相槌・割り込み制御に対応)」です。従来の「音声認識+LLM+音声合成」の3段構成ではなく、音声を直接処理することで約0.61秒の低遅延と自然な相槌・割り込み応答、会話中の外部ツール実行を両立しています。
開発者やクリエイターはどこからPhonic-1を試せますか?
最大の強みは「会話を止めずにバックグラウンドで外部API・ツールを呼び出す機能」となっています。ツール呼び出しを組み込む際は、APIスキーマを最小限に絞るとともに相槌ストリームを有効にすると、データベース照会中の待ち時間を自然に埋められます。




