Das Wichtigste in Kürze
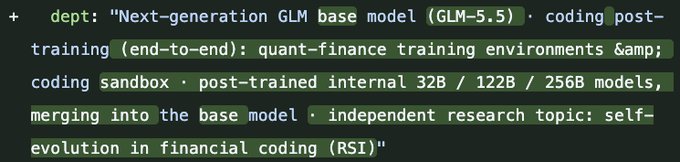
- Trainings-Leak zu Zhipu AIs „GLM-5.5“: Drei Größen mit 32B, 122B und 256B im Post-Training (Entwickler: Zhipu AI; Modellgrößen: Drei interne Varianten mit 32B, 122B und 256B Parametern).
- Warum die 32B-Variante mit 16 GB RAM-Bedarf perfekt für lokale Laptops ist (Entwicklungsstand: Fortgeschrittenes Post-Training und Modell-Merging).
- Positionierung der großen 122B- und 256B-Modelle für komplexe Agenten-Aufgaben (Local-LLM-Faktor: 32B-Modell passt mit 4-Bit-Quantisierung in rund 16 GB Speicher).
Kurzüberblick
| Entwickler | Zhipu AI |
|---|---|
| Modellgrößen | Drei interne Varianten mit 32B, 122B und 256B Parametern |
| Entwicklungsstand | Fortgeschrittenes Post-Training und Modell-Merging |
| Local-LLM-Faktor | 32B-Modell passt mit 4-Bit-Quantisierung in rund 16 GB Speicher |
| Kategorie | KI & Modelle |
| Urheber | Lumina |
| Trend-Index | 🔥 142,3 Tsd. Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
Trainings-Leak zu Zhipu AIs „GLM-5.5“: Drei Größen mit 32B, 122B und 256B im Post-Training
Laut Benchmark-Tracker Lumina befindet sich „GLM-5.5“ von Zhipu AI bereits weit im Post-Training und umfasst intern drei Modellgrößen mit 32B, 122B und 256B Parametern.
Warum die 32B-Variante mit 16 GB RAM-Bedarf perfekt für lokale Laptops ist
Vor allem die 32B-Variante weckt großes Interesse in der Local-LLM-Szene, da sie mit 4-Bit-Quantisierung in rund 16 GB Arbeitsspeicher passt.
Positionierung der großen 122B- und 256B-Modelle für komplexe Agenten-Aufgaben
Da es sich um vorab durchgesickerte Trainingsdaten handelt, sollten endgültige Spezifikationen bis zur offiziellen Vorstellung mit Vorsicht betrachtet werden.
Häufige Fragen
Welche technischen Daten und Preise sind zu GLM-5.5 Post-Training-Leak durchgesickert?
Entwickler: Zhipu AI; Modellgrößen: Drei interne Varianten mit 32B, 122B und 256B Parametern; Entwicklungsstand: Fortgeschrittenes Post-Training und Modell-Merging. Vor allem die 32B-Variante weckt großes Interesse in der Local-LLM-Szene, da sie mit 4-Bit-Quantisierung in rund 16 GB Arbeitsspeicher passt.
Wie ist dieser Leak vor einer offiziellen Ankündigung einzuordnen?
Local-LLM-Faktor: 32B-Modell passt mit 4-Bit-Quantisierung in rund 16 GB Speicher. Da es sich um vorab durchgesickerte Trainingsdaten handelt, sollten endgültige Spezifikationen bis zur offiziellen Vorstellung mit Vorsicht betrachtet werden.




