Puntos clave
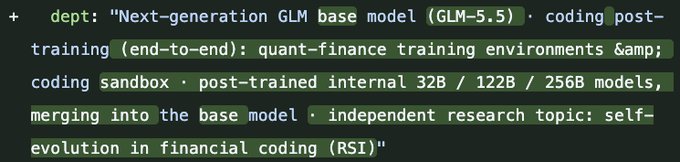
- Filtración de «GLM-5.5» de Zhipu AI: tres variantes de 32B, 122B y 256B en post-entrenamiento (Desarrollador: Zhipu AI; Tamaños filtrados: Variantes internas de 32B, 122B y 256B parámetros).
- Por qué el modelo de 32B entusiasma para uso local al caber en 16 GB de memoria (Fase actual: Post-entrenamiento avanzado y fusión de modelos).
- El papel de los modelos de 122B y 256B en programación autónoma a la espera del anuncio oficial (Atractivo local: El modelo de 32B cabe en ~16 GB de memoria con cuantización de 4 bits).
Datos rápidos
| Desarrollador | Zhipu AI |
|---|---|
| Tamaños filtrados | Variantes internas de 32B, 122B y 256B parámetros |
| Fase actual | Post-entrenamiento avanzado y fusión de modelos |
| Atractivo local | El modelo de 32B cabe en ~16 GB de memoria con cuantización de 4 bits |
| Categoría | IA y modelos |
| Creador | Lumina |
| Popularidad | 🔥 142,3K Popularidad |
| Publicado | |
| Última actualización |
Filtración de «GLM-5.5» de Zhipu AI: tres variantes de 32B, 122B y 256B en post-entrenamiento
Según el rastreador de benchmarks Lumina, la próxima generación GLM-5.5 de Zhipu AI se encuentra avanzada en su fase de post-entrenamiento con variantes internas de 32B, 122B y 256B parámetros.
Por qué el modelo de 32B entusiasma para uso local al caber en 16 GB de memoria
La variante de 32B despierta especial interés para ejecución local, ya que cuantizada a 4 bits cabe en unos 16 GB de memoria unificada.
El papel de los modelos de 122B y 256B en programación autónoma a la espera del anuncio oficial
Al tratarse de datos filtrados antes del anuncio oficial, conviene esperar a la ficha técnica definitiva para confirmar qué pesos se publicarán en abierto.
Preguntas frecuentes
¿Qué especificaciones y precios se han filtrado sobre Filtración de GLM-5.5 en post-entrenamiento?
Desarrollador: Zhipu AI; Tamaños filtrados: Variantes internas de 32B, 122B y 256B parámetros; Fase actual: Post-entrenamiento avanzado y fusión de modelos. La variante de 32B despierta especial interés para ejecución local, ya que cuantizada a 4 bits cabe en unos 16 GB de memoria unificada.
¿Cómo deben interpretar los desarrolladores esta filtración antes del anuncio oficial?
Atractivo local: El modelo de 32B cabe en ~16 GB de memoria con cuantización de 4 bits. Al tratarse de datos filtrados antes del anuncio oficial, conviene esperar a la ficha técnica definitiva para confirmar qué pesos se publicarán en abierto.




