Puntos clave
- Ornith publicó pesos abiertos de un modelo de mezcla de expertos: 122.000 millones de parámetros totales y unos 10.000 millones activos por inferencia, bajo licencia MIT.
- La compañía destaca programación y uso con agentes, y afirma que corre en una sola tarjeta NVIDIA DGX.
- El código y las instrucciones están en huggingface.co; en Ollama hay una versión comprimida de 35 GB pensada para un Mac con 64 GB de memoria.
Datos rápidos
| Arquitectura | Mezcla de expertos, 122B totales y 10B activos |
|---|---|
| Licencia | MIT, pesos abiertos |
| Dónde corre | Una NVIDIA DGX; build de 35 GB en un Mac de 64 GB |
| Acceso | Repositorio en huggingface.co y ficha en Ollama |
| Categoría | IA y modelos |
| Creador | Ornith |
| Sitio oficial | huggingface.co ↗ |
| Popularidad | 🔥 1,5M Popularidad |
| Publicado | |
| Última actualización |
Fuerte y rápido, según Ornith
Sin renunciar a lo fuerte ni a lo rápido: más capaz, más veloz y más ligero.
Ornith presentó Ornith-1.5-122B como un modelo de generación de texto que no obliga a elegir entre calidad y velocidad. La ficha técnica que acompaña el lanzamiento describe una mezcla de expertos: 122.000 millones de parámetros en total y cerca de 10.000 millones activos en cada inferencia. Esa activación parcial es el argumento de eficiencia. Ornith habla de un mejor seguimiento de instrucciones, una descomposición de tareas más sólida y una lectura más fina de flujos de trabajo reales.
El material oficial está en el repositorio ornith-ai/Ornith-1.5-122B de huggingface.co, con pesos abiertos bajo MIT. El resumen automático de esa página lo describe como un modelo de generación de texto de 125.000 millones de parámetros. El nombre, el anuncio y la cifra de activación hablan de 122.000 millones totales: antes de citar el tamaño en un informe, conviene leer la tarjeta del modelo y no solo el metadato.
Programación y agentes, en cifras de la casa
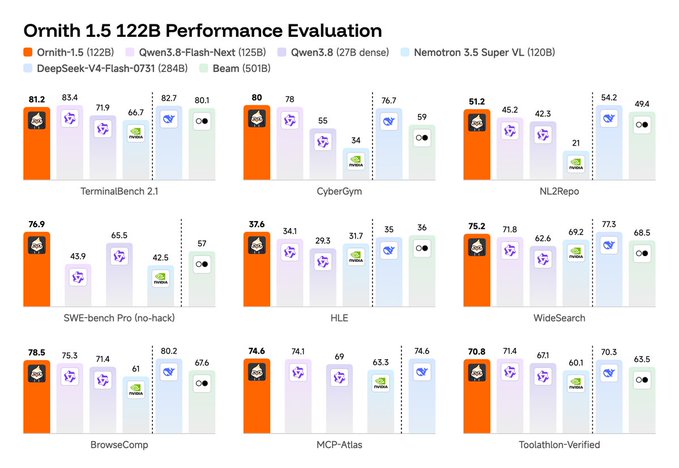
Ornith sitúa el modelo en lo más alto entre los modelos abiertos de tamaño comparable y publica dos bloques de resultados: uno de código y otro de trabajo agéntico. No nombra, en el anuncio, un rival concreto ni adjunta una auditoría externa. Las puntuaciones sirven para ver el acento del producto: bancos de ingeniería de software, repositorios a partir de lenguaje natural, navegación, herramientas y protocolos de agentes.
La otra mitad de la promesa es el hardware. Ornith afirma que Ornith-1.5-122B alcanza ese nivel y, a la vez, corre en una sola tarjeta NVIDIA DGX. Es una afirmación de la compañía sobre inferencia, no una medición independiente de vatios, latencia o precio por token.
| Ámbito | Prueba | Resultado publicado |
|---|---|---|
| Programación | SWE-bench Verified | 0,845 |
| Programación | TB2.1 | 0,813 |
| Programación | CyberGym | 0,800 |
| Programación | NL2Repo | 0,512 |
| Agentes | HLE | 0,446 |
| Agentes | BrowseComp | 0,785 |
| Agentes | MCP-Atlas | 0,746 |
| Agentes | Toolathlon | 0,708 |
Del repositorio a tu máquina
No hay una tarifa de API alojada en el anuncio. El camino oficial es el repositorio: código, instrucciones, inicio rápido, servicio del modelo, uso mediante la API de chat completions, uso agéntico, notas para CLIs de programación, cita y árbol de modelos. También aparecen spaces que ya lo cargan y una colección que lo incluye. El dominio de referencia es huggingface.co.
En paralelo, el modelo está en Ollama. La versión comprimida ocupa 35 GB y el lanzamiento indica que puede ejecutarse en local en un Mac con 64 GB de memoria. Es el atajo si no quieres montar a mano el servicio de la ficha completa.
- Inicio rápido
El apartado Quickstart del repositorio explica cómo cargar los pesos y arrancar una primera generación.
- Servirlo tú
Serving y la API de chat completions documentan cómo exponer el modelo en tu propia infraestructura.
- Agentes y CLIs
Hay apartados de uso agéntico y de CLIs de programación para engancharlo a herramientas y flujos de código.
- Ollama
La build comprimida de 35 GB es la vía local que el lanzamiento asocia a un Mac de 64 GB de RAM.
Qué queda por comprobar
Las cifras de la tabla y la frase de referencia entre modelos abiertos de tamaño similar salen de Ornith. En el material reunido aquí no hay contexto máximo, desglose de cuantización de cada variante ni un coste de tokens si lo alojas. La licencia MIT permite usar, modificar y redistribuir los pesos dentro de lo que diga ese texto; el gasto real es el de tu GPU, tu Mac o el servidor que montes.
Encaja como asistente de código, como modelo de agentes con herramientas y como base de flujos internos que quepan en una DGX o, con la build corta, en un Mac de mucha memoria. Antes de fiarte del 0,845 o del 0,785 en tu propio repositorio, mide con tus tareas: el anuncio marca el techo que la compañía reclama, no el resultado en tu código.
Guía paso a paso
Abre la ficha oficial
Entra en el repositorio ornith-ai/Ornith-1.5-122B en huggingface.co y revisa la licencia MIT, los archivos de pesos y el apartado Quickstart.
Elige cómo ejecutarlo
Sigue Serving si vas a montarlo en una NVIDIA DGX, o busca la versión de Ollama si quieres la build comprimida de 35 GB en un Mac con 64 GB de memoria.
Haz una primera llamada
Usa la guía de la API de chat completions para un mensaje de prueba y comprueba que la generación responde como esperas.
Pasa a agentes o a código
Si la prueba base va bien, sigue Agentic Usage o las notas de Coding CLIs para conectarlo a herramientas y a tu flujo de programación.
Preguntas frecuentes
¿Por qué unas fuentes dicen 122B y la ficha menciona 125B?
El anuncio y la descripción de la mezcla de expertos hablan de 122.000 millones totales y 10.000 millones activos. El metadato de la página en huggingface.co dice 125.000 millones. Usa la tarjeta del modelo como referencia cuando cites el tamaño.
¿Hay un precio de uso en la nube?
En el anuncio no aparece una tarifa. Los pesos son abiertos con licencia MIT; el coste es el de ejecutarlos en una NVIDIA DGX, en el Mac de 64 GB con la build de 35 GB, o en el servicio que montes tú.