핵심 요약
- 맥스벤치는 DeepSWE 89문항에 지시문이나 시작 코드의 작은 변경을 넣은 벤치마크예요.
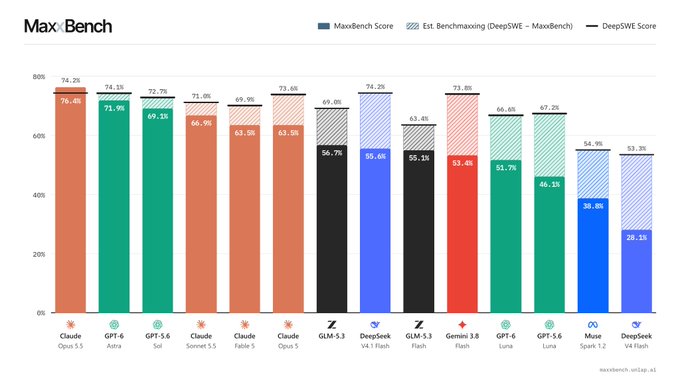
- DeepSWE에서 약 74%로 모여 있던 모델이 변형 뒤에는 최대 23%포인트 차이 나요.
- 공개 빌드와 공식 페이지는 아직 없고, Opus 5.5가 가장 안정적이라는 정리만 있어요.
한눈에 보기
| 만든 사람 | Justin Lo |
|---|---|
| 구성 | DeepSWE 89문항, 지시문 또는 시작 코드를 소폭 변경 |
| 관찰 | 약 74%대 모델이 최대 23%포인트로 분산, Opus 5.5가 가장 안정 |
| 이용 | 공개 빌드·다운로드·공식 페이지 없음 |
| 카테고리 | AI·모델 |
| 제작자 | Justin Lo |
| 화제도 | 🔥 화제도 57만 |
| 공개일 | |
| 최종 업데이트 |
같은 문제, 살짝 다른 요구
코딩을 잘하나요, 아니면 DeepSWE를 잘하나요?
맥스벤치는 새 코딩 모델이 아니라, 기존 DeepSWE 과제가 작은 변화에도 같은 난이도로 남는지 보는 벤치마크예요. Justin Lo는 파일명을 소문자로 바꿨을 때도 점수가 유지되는지를 물으며 소개했고, 실제 세트는 89개 과제에서 지시문이나 시작 코드를 조금씩 바꾼 형태예요.
풀어야 할 공학 문제는 같고, 요구만 약간 달라요. 원점수만으로는 모델이 코딩 자체에 강한지, 벤치 문항에 맞춘 풀이에 강한지 구분하기 어렵다는 문제의식이에요.
- 바꾸는 대상
지시문 또는 시작 코드의 작은 수정이에요. 문제의 뼈대는 DeepSWE 그대로예요.
- 소개에 나온 예
파일명을 소문자로 바꿨을 때도 풀이가 버티는지가 대표적인 질문으로 제시됐어요.
- 문항 규모
변형이 들어간 과제는 89개예요.
74% 근처가 갈라지는 지점
DeepSWE에서는 비교 대상 모델이 74% 안팎에 모여 있었어요. 같은 문제를 맥스벤치 조건으로 다시 보면 그 간격이 최대 23%포인트까지 벌어져요. 편집 정리에서는 Opus 5.5가 가장 안정적이었어요.
모델별 정확한 점수표, 어떤 변경이 몇 문항에 들어갔는지는 이번 소개에 숫자로 공개되지 않았어요. 그래서 23%포인트는 군집이 얼마나 흩어졌는지를 보여주는 폭이고, 특정 모델의 절대 점수로 읽기는 어려워요.
| 보는 기준 | 지금까지 알려진 결과 |
|---|---|
| DeepSWE 원점수 | 비교 모델이 약 74% 근처에 모임 |
| 맥스벤치 변형 후 | 같은 집단이 최대 23%포인트까지 분산 |
| 안정성 | Opus 5.5가 가장 안정. 세부 점수는 미공개 |
확인할 수 있는 범위와 남은 질문
공개 빌드, 다운로드, 공식 페이지는 아직 없어요. 지금까지는 짧은 미리보기 소개만 나온 상태라, 문항 파일을 받아 직접 재현하거나 API로 돌리는 경로는 없어요.
평가 담당자에게는 원점수가 비슷한 모델을 변형 문항으로 다시 견주는 용도가 분명해요. 다만 변경 규칙 전체, 채점 방식, 전체 모델 목록, 세트가 나중에 공개될지는 열려 있어요. 파일명 대소문자처럼 작은 요구 변화가 점수에 얼마나 민감한지도 과제별로 확인되려면 원문이 필요해요.
자주 묻는 질문
맥스벤치를 지금 내려받거나 공식 페이지에서 볼 수 있나요?
아니요. 공개 빌드, 다운로드, 공식 페이지는 아직 없고, 2026년 11월 7일 짧은 미리보기 소개만 나왔어요.
23%포인트는 특정 모델의 점수 하락인가요?
아니요. DeepSWE에서 약 74%로 모여 있던 모델들 사이의 간격이 변형 뒤 최대 23%포인트로 벌어졌다는 뜻이에요. Opus 5.5가 가장 안정적이라는 점 외에 모델별 점수는 공개되지 않았어요.