一分钟看懂
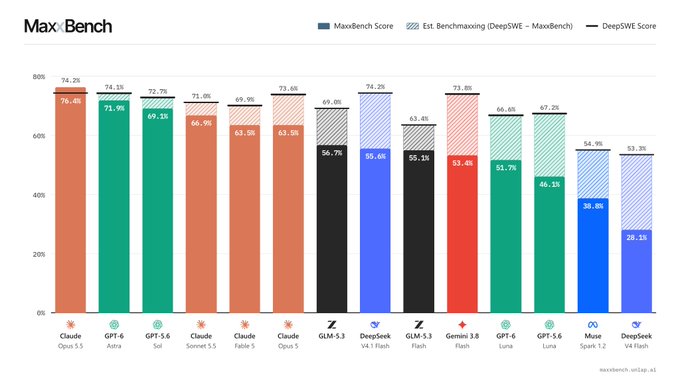
- MaxxBench保留DeepSWE的工程问题,只改89道题的指令或起始代码。
- 原成绩约74%的模型在这套题上相差23个百分点,Opus 5.5最稳。
- 目前只有短预告,没有公开版本、下载或官方页面。
基本信息
| 题目规模 | 89道,取自DeepSWE |
|---|---|
| 改动方式 | 指令或起始代码的小幅变动 |
| 分数现象 | 约74%聚成一团后拉开23个百分点 |
| 公开程度 | 2026年11月7日仅预告,无公开版本 |
| 分类 | AI 前沿 |
| 作者 / 发布方 | Justin Lo |
| 热度 | 🔥 热度 57万 |
| 发布时间 | |
| 数据更新 |
同一道工程题,换一种细小要求
会写代码,还是只会做DeepSWE?
MaxxBench(一套扰动版编程基准)由Justin Lo提出,材料来自DeepSWE的89道编程题。要解决的工程问题保持不变,改动落在指令措辞或动手前的起始代码上,用来看模型会不会被几乎等价的新要求带偏。
预告用文件名改成小写之后还能不能通过来说明这种扰动有多轻。题目骨架仍是原来的工程任务,验收条件只挪了一点,专门检验模型是理解任务,还是死扣见过的题面。
- 指令
同一工程目标,要求的说法被稍微改写。
- 起始代码
开始动手时给出的代码片段有小幅不同。
- 表面细节
预告点名的一类例子是文件名大小写这类轻改动。
74%附近的模型被拉开
在原始DeepSWE上,这些模型的成绩挤在74%上下,看上去差不多。换到MaxxBench之后,高低相差23个百分点,其中Opus 5.5最稳。
聚在同一分数带,并不等于需求措辞一变仍然一样牢靠。预告没有公布其余模型的逐项分数,也没有放出完整题库,这23个百分点是整体跨度,还不是一张可以逐行核对的排行榜。
| 观察 | 原始DeepSWE | MaxxBench |
|---|---|---|
| 题目 | 同一批工程题 | 89道,指令或起始代码有小改动 |
| 成绩 | 模型聚在约74% | 高低相差23个百分点 |
| 稳定性线索 | 预告未另行拆开 | Opus 5.5最稳 |
现在还不能调用或复现
截至这次预告,没有公开构建、下载包或官方页面,外界只能看到一段很短的演示。因此不存在注册入口、接口、开放权重或定价。
对做评测的人,它的意义是提醒:报告编程能力时,最好同时看需求被轻微改写后的成绩。题库和评分方式公开之前,23个百分点只适合当作方向性信号。
常见问题
MaxxBench现在能下载或调用吗?
不能。创作者只放出短预告,没有公开版本、下载或官方页面。
23个百分点是某一道题的分差吗?
不是单题分差。它指原先聚在约74%的模型,在整套89道扰动题上的整体差距。