핵심 요약
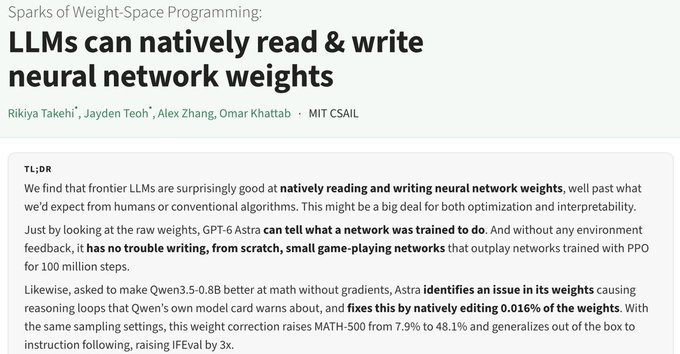
- GPT-6 Astra가 도구 없이 원본 가중치만 보고 네트워크가 무엇을 배웠는지 가려내요.
- Qwen3.5-0.8B 가중치 0.016%만 고쳐 MATH-500을 7.9%에서 48.1%로, IFEval은 3배로 올렸어요.
- 전문은 리키야 타케히의 공식 페이지 rikiyat.github.io에 있고, 앱이나 API 상품은 아니에요.
한눈에 보기
| 발표 | 2026년 11월 2일 |
|---|---|
| 소속 | MIT CSAIL |
| 편집 비율 | Qwen3.5-0.8B의 0.016% |
| 공식 페이지 | rikiyat.github.io |
| 카테고리 | AI·모델 |
| 제작자 | Rikiya Takehi |
| 공식 사이트 | rikiyat.github.io ↗ |
| 화제도 | 🔥 화제도 401만 |
| 공개일 | |
| 최종 업데이트 |
가중치만 보고 행동을 읽어요
프론티어 LLM은 사람이나 기존 알고리즘에 기대하던 수준을 넘어 신경망 가중치를 직접 읽고 쓴다.
리키야 타케히, 제이든 테오, 알렉스 장, 오마르 카탑은 모두 MIT CSAIL 소속이에요. 이들이 부른 가중치 공간 프로그래밍은 Astra가 학습 루프를 짜지 않은 채, 신경망의 각 부분이 무엇을 계산하는지 또는 무엇을 계산해야 하는지를 추론하고 가중치를 그에 맞게 바꾸는 방식이에요. 팀은 최적화와 해석 가능성 양쪽에 큰 의미가 있을 수 있다고 봐요.
읽기 쪽에서는 원본 가중치만으로 네트워크가 무엇을 하도록 학습됐는지 맞혀요. 도구 없이 가중치 17,253개를 읽고, 그 네트워크가 학습한 게임을 Breakout으로 99% 확신과 함께 지목한 사례가 대표적이에요. 확산 모델이 무엇을 생성할지, 언어 모델의 중간층만으로 무엇을 배웠는지를 가리는 질문도 같은 글에서 다뤄요.
- 읽기
게임, 확산 모델, 언어 모델의 학습 내용을 가중치에서 추론해요.
- 쓰기
환경 피드백 없이 작은 게임 플레이 네트워크를 처음부터 작성해요.
- 고치기
실패하는 네트워크의 가중치를 직접 편집해 동작을 바로잡아요.
016% 수정이 바꾼 수학
Astra는 학습 루프를 쓰지 않고, 추론으로 각 부분이 계산하는 바를 파악한 뒤 가중치를 바꾼다.
수학을 더 잘하게 만들라는 과제에서 Astra는 Qwen3.5-0.8B 가중치 안의 추론 루프 원인을 집어냈어요. 이 루프는 Qwen 모델 카드가 이미 경고한 현상이었어요. 그래디언트나 추가 학습 없이 전체 가중치의 0.016%만 고쳤고, 샘플링 설정은 그대로였어요.
같은 조건에서 MATH-500은 7.9%에서 48.1%로 올랐어요. 발표문은 이 수학 개선을 최대 약 6배로 설명해요. 효과는 수학에만 머물지 않고 지시 따르기로 이어져 IFEval이 3배가 됐어요. 별도 실험에서는 환경 피드백 없이 처음부터 쓴 작은 게임 네트워크가, PPO로 1억 스텝 학습한 네트워크를 이겼다고 해요.
| 항목 | 수정 전 | 수정 후 |
|---|---|---|
| MATH-500 | 7.9% | 48.1% |
| IFEval | 기준선 | 3배 |
| 건드린 가중치 | — | 0.016% |
공식 페이지와 아직 열린 질문
신경망 가중치는 곧 그 가중치를 두고 의도적으로 추론하는 LLM이 직접 최적화하게 될 것이다.
전문은 rikiyat.github.io의 2026년 11월 2일 글에서 볼 수 있어요. 내려받는 앱, API, 공개 가중치 패키지나 요금제는 안내되어 있지 않아요. 재현은 이 연구 글을 따라가는 형태예요.
글은 규모를 키우고 도구를 쓰는 현실적인 시나리오도 열어요. 바둑 알고리즘을 쓰는지, 어떤 언어 모델이 아첨적인지, 루프가 없는 모델의 수학 능력을 올릴 수 있는지가 그 질문이에요. 각 시나리오의 세부 수치와 다른 모델로의 일반화 범위는 발표 요약만으로는 확정하기 어려워요.
자주 묻는 질문
학습이나 그래디언트 없이 고친 건가요?
그래디언트와 추가 학습 없이, Astra가 학습 루프를 작성하지 못한 상태에서 가중치만 읽고 고쳤어요.
일반 사용자가 바로 호출할 제품인가요?
아니요. 공식 경로는 rikiyat.github.io의 연구 글이고, 앱·API·요금 안내는 없어요.