Das Wichtigste in Kürze
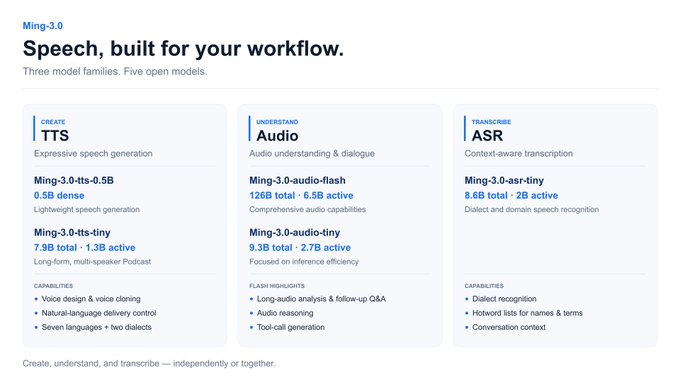
- Ming-3.0 umfasst fünf Modelle in drei Familien: TTS (0,5B und Tiny 7,9B A1,3B), Audio (Flash 126B A6,5B und Tiny 9,3B A2,7B) sowie ASR (Tiny 8,6B A2B).
- Das 0,5B-TTS-Modell kann Stimmen klonen, neue Stimmen aus Textbeschreibungen erzeugen und paralinguistische Signale wie Lachen oder Seufzen einfügen.
- Alle Modelle stehen unter der MIT-Lizenz, laufen über offiziellen Inferenzcode und wurden laut Angaben am ersten Tag von vLLM unterstützt.
- Eine eigene Produktseite fehlt bislang; Modelle und Informationen findest du auf der offiziellen Seite huggingface.co.
Kurzüberblick
| Typ | Offene Sprachmodell-Familie (TTS, Audio, ASR) |
|---|---|
| Geräte | Server/GPU; kleine Varianten auch lokal |
| Kosten | Kostenlos nutzbar unter MIT-Lizenz |
| Sprachen | Mehrsprachig; Details auf huggingface.co prüfen |
| Highlight | 0,5B-TTS mit Stimmklonen und Paralinguistik |
| Einstieg | Modellkarten und Inferenzcode auf huggingface.co |
| Kategorie | KI & Modelle |
| Urheber | Ant Ling |
| Offizielle Seite | huggingface.co ↗ |
| Trend-Index | 🔥 1 Mio. Trend-Index |
| Zuletzt aktualisiert |
Was Ming-3.0 ist und wer dahintersteht
Ming-3.0 ist eine Sammlung von fünf offenen Sprachmodellen, die Ant Groups Team inclusionAI am 19. Oktober 2026 veröffentlicht hat. Sie verteilen sich auf drei Familien: Ming-3.0-tts für Sprachsynthese, Ming-3.0-audio für Audioverständnis und Dialog sowie Ming-3.0-asr für Spracherkennung. Alle Modelle stehen unter der MIT-Lizenz, was kommerzielle Nutzung und eigene Anpassungen grundsätzlich erlaubt. Eine eigene Produktseite gibt es noch nicht; die Modelle und Informationen liegen auf der offiziellen Seite huggingface.co.
Die Familie ist bewusst unterschiedlich dimensioniert. Das TTS-Feld reicht vom kleinen 0,5B-Modell für Stimmdesign und paralinguistische Signale bis zum Tiny-Modell mit 7,9B Gesamtparametern und 1,3B aktiven Parametern für langformatige Sprache. Bei Audio stehen ein Flash-Modell mit 126B Gesamt- und 6,5B aktiven Parametern für Verständnis und Werkzeuge sowie ein Tiny-Modell mit 9,3B Gesamt- und 2,7B aktiven Parametern für effizienten Dialog bereit. Die ASR-Familie wird durch ein Tiny-Modell mit 8,6B Gesamt- und 2B aktiven Parametern für Dialekte und Kontext abgedeckt.
Derzeit im Trend liegt die Familie, weil das 0,5B-TTS-Modell in Community-Berichten als Nummer eins der offenen steuerbaren Sprachmodelle auf der Plattform Artificial Analysis genannt wird, mit einem Elo-Wert von 1069. Dieser Wert stammt aus Community-Angaben und ist nicht offiziell bestätigt; prüfe den aktuellen Stand auf huggingface.co. Unabhängig davon ist die Kombination aus kleiner Modellgröße, MIT-Lizenz und breiter Aufgabenabdeckung ein starkes Argument für eigene Experimente.
- Drei Familien, fünf Modelle
TTS, Audio und ASR decken Sprachausgabe, Audioanalyse und Transkription ab. So lässt sich fast eine komplette Sprachpipeline aus einer Hand bauen.
- MIT-Lizenz
Die offene Lizenz erlaubt kommerzielle Nutzung und Modifikation. Prüfe trotzdem die Modellkarten auf huggingface.co auf zusätzliche Hinweise.
- vLLM-Unterstützung ab Tag eins
Laut Ankündigung unterstützte vLLM die Modelle sofort. Das erleichtert den Betrieb auf vorhandener GPU-Infrastruktur erheblich.
- Community-Ranking
Das 0,5B-TTS soll laut Community-Angaben die offene Bestenliste für steuerbare Sprache anführen. Ein offizieller Beleg dafür steht noch aus.
TTS, Audioverständnis und ASR im Detail
Das 0,5B-TTS-Modell ist das vielseitigste Einzelmodell der Familie. Es kann vorhandene Stimmen klonen, aus einer Textbeschreibung heraus völlig neue Stimmen erzeugen und paralinguistische Signale wie Lachen oder Seufzen in die Ausgabe einbauen. Damit eignet es sich für Hörspiele, Spiele-Charaktere, Podcasts und barrierefreie Anwendungen, bei denen nicht nur Wörter, sondern auch Emotion und Timing zählen. Die genauen Steuerungsbefehle und Grenzen des Stimmklonens solltest du der Modellkarte auf huggingface.co entnehmen.
Die größeren TTS- und Audio-Modelle setzen andere Schwerpunkte. Das Tiny-TTS-Modell mit 7,9B Gesamt- und 1,3B aktiven Parametern ist auf langformatige Sprache ausgelegt, also längere Erzähltexte oder Dialoge in einem Durchgang. Beim Audioverständnis übernimmt das Flash-Modell mit 126B Gesamt- und 6,5B aktiven Parametern Aufgaben wie Analyse und Werkzeugnutzung, während das Tiny-Modell mit 9,3B Gesamt- und 2,7B aktiven Parametern auf effizienten Dialog optimiert ist. Die ASR-Variante mit 8,6B Gesamt- und 2B aktiven Parametern zielt auf Dialekte und kontextabhängige Transkription.
Die Aufteilung in Gesamt- und aktive Parameter ist ein Hinweis auf sparsam aktivierte Architekturen, wie sie bei modernen Sprachmodellen üblich sind. Dadurch bleibt der Rechenaufwand pro Token deutlich niedriger als die Gesamtgröße vermuten lässt. Für Einsteiger bedeutet das: Das 0,5B-TTS läuft vergleichsweise genügsam, während die großen Varianten echte GPU-Ressourcen brauchen. Konkrete Speicher- und Hardwareanforderungen stehen nicht in der Ankündigung; kläre sie vor dem Deployment auf huggingface.co.
- Stimmklonen und Stimmdesign
Das 0,5B-TTS kann bestehende Stimmen nachbilden und neue Stimmen allein aus einer Textbeschreibung erzeugen. Das macht es für Prototyping und kreative Projekte interessant.
- Paralinguistische Signale
Lachen, Seufzen und ähnliche Äußerungen lassen sich einbauen, was die Ausgabe natürlicher wirken lässt. Wie präzise die Steuerung ist, zeigt die Modellkarte.
- Langform und Dialog
Das Tiny-TTS deckt lange Texte ab, die Audio-Tiny-Variante effizienten Dialog. So kannst du je nach Anwendungsfall das passende Modell wählen.
- Dialekte und Kontext in der ASR
Das ASR-Modell ist auf Dialekte und kontextabhängige Erkennung ausgelegt. Das hilft bei Transkriptionen, die über Standardsprache hinausgehen.
So startest du mit Ming-3.0 in der Praxis
Der Einstieg läuft über die Modellkarten und den offiziellen Inferenzcode auf huggingface.co. Dort findest du die Gewichte, Beispielaufrufe und Hinweise zur Einrichtung. Für einen ersten Test empfiehlt sich das 0,5B-TTS-Modell, weil es klein ist und schnell Ergebnisse liefert. Wenn du bereits vLLM nutzt, kannst du die Modelle laut Ankündigung direkt darüber betreiben, was den Wechsel von Test zu Produktion vereinfacht.
Plane vor dem Produktiveinsatz eine Testphase mit kurzen Sätzen ein, die Namen, Zahlen und Satzzeichen enthalten. Gerade bei Sprachsynthese zeigen sich Schwächen oft erst bei solchen Details. Prüfe außerdem, wie sich das Modell bei deiner Zielsprache und bei Dialekten verhält, bevor du eine komplette Pipeline darauf aufbaust. Die Ankündigung nennt keine offiziell unterstützten Sprachen im Detail, also verlasse dich auf eigene Tests und die Angaben auf huggingface.co.
Für Audioverständnis und Spracherkennung gilt dasselbe Vorgehen: erst kleine Beispiele, dann längere Aufnahmen. Achte darauf, ob die Ergebnisse für deinen Anwendungsfall stabil genug sind, und vergleiche mit Alternativen. Da es keine dedizierte Produktseite gibt, ist die Community rund um huggingface.co die wichtigste Anlaufstelle für Beispiele und Fehlerbehebung. Rechne damit, dass sich Dokumentation und Modellversionen noch ändern.
- Klein anfangen
Teste zuerst das 0,5B-TTS mit kurzen Sätzen. So erkennst du schnell, ob die Qualität für dein Projekt reicht.
- vLLM nutzen
Wenn du vLLM bereits einsetzt, spare dir eigenen Inferenzcode und nutze die bestehende Unterstützung. Das beschleunigt den Einstieg.
- Details prüfen
Sprachen, Lizenzen und Hardwareanforderungen stehen nicht vollständig in der Ankündigung. Lies die Modellkarten auf huggingface.co sorgfältig.
- Eigene Tests statt Versprechen
Verlasse dich bei Qualität und Stabilität auf eigene Messungen. Community-Angaben wie der Elo-Wert sind Momentaufnahmen.
Vergleich, Grenzen und für wen sich Ming-3.0 lohnt
Im Vergleich zu vielen kommerziellen Sprachdiensten punktet Ming-3.0 mit Offenheit: Die MIT-Lizenz erlaubt eigene Anpassungen und den Betrieb auf eigener Infrastruktur. Das ist besonders für Teams interessant, die Datenhoheit brauchen oder ihre Modelle feinabstimmen wollen. Gegenüber anderen offenen Sprachmodell-Familien sticht die breite Abdeckung von TTS über Audioverständnis bis ASR hervor, sodass du mehrere Bausteine aus einem Ökosystem kombinieren kannst.
Die Grenzen liegen auf der Hand. Es gibt bislang keine eigene Produktseite und keine offiziell bestätigten Benchmark-Zahlen außer dem Community-Hinweis auf 1069 Elo im Bereich steuerbare Sprache. Auch zu unterstützten Sprachen, Lizenzdetails einzelner Varianten und Hardwareanforderungen schweigt die Ankündigung teilweise. Wer rechtliche Sicherheit oder Garantien braucht, sollte die Modellkarten prüfen und gegebenenfalls eigene Evaluierungen durchführen, bevor Ming-3.0 in kritische Anwendungen geht.
Geeignet ist Ming-3.0 für Entwickler, Forschende und Kreativteams, die Sprachfunktionen selbst hosten oder anpassen möchten. Für Anwender, die einfach nur schnell eine fertige Sprach-App suchen, sind kommerzielle Dienste mit fertiger Oberfläche oft bequemer. Wenn du dagegen experimentieren, Stimmen designen oder eine eigene Sprachpipeline bauen willst, ist die Familie einen genauen Blick auf huggingface.co wert.
- Offenheit als Vorteil
MIT-Lizenz und offene Gewichte erlauben Anpassung und Self-Hosting. Das unterscheidet Ming-3.0 von vielen kommerziellen APIs.
- Breite statt Spezialisierung
Die Familie deckt TTS, Audioverständnis und ASR ab. Du kannst mehrere Aufgaben mit einem Ökosystem lösen.
- Unbestätigte Angaben
Der Elo-Wert von 1069 stammt aus Community-Berichten. Offizielle Bestätigung und Details zu Sprachen fehlen noch.
- Zielgruppe
Entwickler und Kreativteams mit eigener Infrastruktur profitieren am meisten. Für Endanwender ohne Technikhintergrund ist der Einstieg aufwendig.
Schritt-für-Schritt-Anleitung
Modellkarten auf huggingface.co ansehen
Besuche die offizielle Seite huggingface.co und suche nach den Ming-3.0-Modellen von inclusionAI. Dort findest du Beschreibungen, Lizenzhinweise und Beispielaufrufe für alle fünf Varianten. Verschaffe dir zuerst einen Überblick, bevor du etwas installierst.
Das passende Modell auswählen
Für Stimmklonen und Stimmdesign nimmst du das 0,5B-TTS-Modell. Für lange Texte das Tiny-TTS, für Dialog und Audioanalyse die Audio-Varianten und für Transkription das ASR-Modell. Orientiere dich an deinem konkreten Anwendungsfall und an deiner Hardware.
Inferenzcode einrichten
Lade den offiziellen Inferenzcode und die Modellgewichte von huggingface.co und folge der Anleitung zur Installation. Wenn du vLLM nutzt, kannst du die Modelle laut Ankündigung direkt darüber betreiben. Prüfe vor dem Start, ob deine GPU-Umgebung die Anforderungen erfüllt.
Erste Tests mit kurzen Sätzen
Erzeuge zunächst kurze Beispielsätze mit Namen, Zahlen und Satzzeichen, um die Qualität einzuschätzen. Teste auch Lachen oder Seufzen, wenn du paralinguistische Signale brauchst. So erkennst du früh, ob das Modell zu deinem Projekt passt.
Skalieren und vergleichen
Wenn die kurzen Tests überzeugen, gehe zu längeren Texten, Dialogen oder Dialektaufnahmen über. Vergleiche die Ergebnisse mit Alternativen und dokumentiere deine Messungen. So entscheidest du fundiert, ob Ming-3.0 in deine Produktion kommt.
Häufige Fragen
Was kostet Ming-3.0 und wo kann ich es herunterladen?
Ming-3.0 steht unter der MIT-Lizenz und ist damit kostenlos nutzbar, auch kommerziell. Die Modelle und der offizielle Inferenzcode liegen auf der Seite huggingface.co. Eine eigene Produktseite mit Preisen gibt es nicht, weil es sich um offene Modelle und nicht um einen kostenpflichtigen Dienst handelt. Prüfe die Modellkarten für Details zu den einzelnen Varianten.
Welche Geräte brauche ich, um Ming-3.0 zu betreiben?
Das 0,5B-TTS-Modell ist vergleichsweise genügsam und kann auch auf kleineren GPUs oder lokal laufen. Die großen Varianten wie das Flash-Audiomodell mit 126B Gesamtparametern brauchen dagegen echte Server-Ressourcen. Konkrete Speicheranforderungen nennt die Ankündigung nicht, daher solltest du die Angaben auf huggingface.co prüfen und eigene Tests einplanen.
Kann Ming-3.0 meine Stimme klonen und neue Stimmen erzeugen?
Ja, das 0,5B-TTS-Modell kann laut Ankündigung Stimmen klonen und aus Textbeschreibungen neue Stimmen erzeugen. Zusätzlich lassen sich paralinguistische Signale wie Lachen oder Seufzen einbauen. Wie genau die Steuerung funktioniert und welche Grenzen gelten, steht in der Modellkarte auf huggingface.co. Kläre vor dem Einsatz die rechtlichen Rahmenbedingungen für Stimmklonen in deinem Land.
Wie schlägt sich Ming-3.0 im Vergleich zu anderen Sprachmodellen?
Community-Berichte nennen für das 0,5B-TTS einen Elo-Wert von 1069 auf der Plattform Artificial Analysis im Bereich steuerbare Sprache, was Platz eins unter den offenen Modellen bedeuten würde. Dieser Wert ist nicht offiziell bestätigt. Der größte Unterschied zu kommerziellen Diensten ist die Offenheit: MIT-Lizenz, eigene Gewichte und Self-Hosting statt reiner API-Nutzung.
Welche Sprachen und Dialekte unterstützt Ming-3.0?
Die Ankündigung nennt keine vollständige Liste unterstützter Sprachen. Das ASR-Modell ist ausdrücklich auf Dialekte und kontextabhängige Erkennung ausgelegt, was auf eine gewisse Bandbreite hindeutet. Für verlässliche Angaben zu deiner Zielsprache solltest du die Modellkarten auf huggingface.co lesen und eigene Tests mit kurzen Sätzen durchführen, bevor du dich festlegst.





