Puntos clave
- Ming-3.0 es una familia de cinco modelos de voz de código abierto bajo licencia MIT, publicada por inclusionAI (Ant Group) el 19 de octubre de 2026.
- El modelo estrella es un TTS de 0.5B que clona voces, crea voces nuevas a partir de descripciones de texto y añade señales paralingüísticas como risas o suspiros.
- La familia se completa con TTS para voz larga, modelos de comprensión de audio con herramientas y un ASR especializado en dialectos y contexto.
- Se ejecuta con el código de inferencia oficial y con vLLM, que dio soporte desde el primer día; los pesos están en el sitio oficial de Hugging Face.
Datos rápidos
| Tipo | Familia de modelos de voz de código abierto (TTS, audio, ASR) |
|---|---|
| Dispositivos | Servidores y equipos con GPU; acceso vía código de inferencia o vLLM |
| Precio | Gratuito bajo licencia MIT; coste de cómputo propio |
| Idiomas | No confirmado en las notas; consulta la ficha oficial |
| Lo destacado | TTS de 0.5B con clonación y control paralingüístico |
| Dificultad | Media; requiere entorno técnico para ejecutar modelos |
| Categoría | IA y modelos |
| Creador | Ant Ling |
| Sitio oficial | huggingface.co ↗ |
| Popularidad | 🔥 1M Popularidad |
| Última actualización |
Qué es Ming-3.0 y quién está detrás
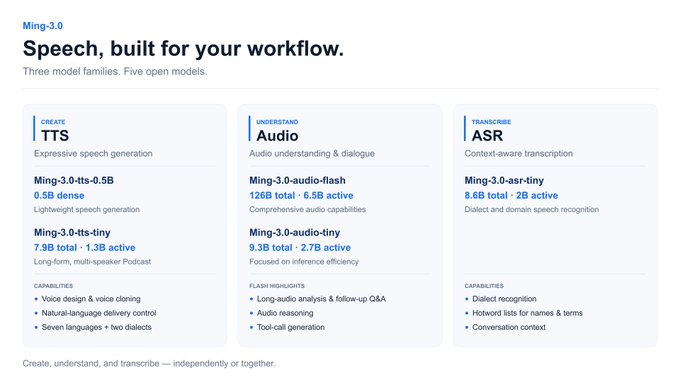
Ming-3.0 es una familia de cinco modelos de voz de código abierto publicada por inclusionAI, el equipo de inteligencia artificial de Ant Group, el 19 de octubre de 2026. La familia cubre tres áreas: síntesis de voz o TTS, comprensión de audio y reconocimiento automático de voz o ASR. Todos los modelos se publican bajo licencia MIT, lo que permite usarlos, modificarlos y redistribuirlos, incluso con fines comerciales, siempre que se respete la atribución de la licencia.
El anuncio oficial describe cinco variantes repartidas en tres familias de voz. En TTS encontramos Ming-3.0-tts, un modelo de 0.5B centrado en diseño de voz y señales paralingüísticas, y una variante Tiny de 7.9B con 1.3B activos para voz de formato largo. En audio están Ming-3.0-audio Flash de 126B con 6.5B activos para comprensión y uso de herramientas, y Tiny de 9.3B con 2.7B activos para diálogo eficiente. La familia ASR incluye Ming-3.0-asr Tiny de 8.6B con 2B activos, orientado a dialectos y contexto.
La notación con dos cifras, como 126B A6.5B, indica un modelo de mezcla de expertos: tiene 126.000 millones de parámetros totales, pero solo activa unos 6.500 millones por token. Eso reduce el coste de inferencia frente a un modelo denso del mismo tamaño. El modelo de 0.5B, en cambio, es pequeño y ligero, pensado para tareas concretas de voz sin necesidad de infraestructura enorme. Los pesos y las fichas están disponibles en el sitio oficial de Hugging Face.
- Cinco modelos, tres familias
TTS para generar voz, audio para entender sonido y ASR para transcribir. Cada familia tiene variantes pequeñas y grandes según el caso de uso.
- Licencia MIT
Permite uso comercial y modificación con atribución. Es una de las licencias más permisivas para modelos abiertos.
- Mezcla de expertos
Los modelos grandes activan solo una fracción de sus parámetros por token, lo que abarata la inferencia en producción.
- Soporte de vLLM desde el día uno
vLLM es un motor de inferencia de alto rendimiento; su soporte inmediato facilita desplegar los modelos en servidores propios.
El TTS de 0.5B: clonación, voces nuevas y risas
El modelo más llamativo de la familia es Ming-3.0-tts de 0.5B. Según el anuncio, es capaz de clonar una voz a partir de una muestra, crear voces completamente nuevas describiéndolas con texto y añadir señales paralingüísticas como risas o suspiros. Esa combinación es poco habitual en un modelo tan pequeño: normalmente la clonación de voz exige modelos de varios miles de millones de parámetros.
El control por descripción de texto significa que puedes pedir una voz con ciertas características, por ejemplo grave y pausada, y el modelo la genera sin necesidad de una grabación de referencia. Las señales paralingüísticas añaden naturalidad a la locución, algo útil en doblaje, audiolibros o asistentes conversacionales donde una risa o un suspiro cambia por completo el tono del mensaje.
La comunidad sitúa a este modelo en lo más alto de la tabla de voz controlable de código abierto de Artificial Analysis, con 1069 Elo. Conviene tratar esa cifra como un dato reportado por la comunidad y no como un resultado verificado de forma independiente; si necesitas certeza, revisa la ficha oficial y la metodología de la tabla antes de tomar decisiones de producción.
- Clonación de voz
Reproduce el timbre de una voz de referencia. Comprueba en la ficha oficial qué duración mínima de muestra recomiendan.
- Voces desde texto
Genera voces nuevas describiéndolas con palabras, sin necesidad de audio de partida. Ideal para personajes ficticios.
- Risas y suspiros
Añade señales paralingüísticas que hacen la locución más humana. Útil en doblaje y contenido narrativo.
- 1069 Elo reportado
La comunidad lo sitúa primero en voz controlable de código abierto en Artificial Analysis. Verifica la metodología antes de citarlo.
Cómo probar Ming-3.0 paso a paso
Ming-3.0 no tiene todavía una página dedicada ni una demo web oficial. Lo que existe son los pesos y el código de inferencia publicados en el sitio oficial de Hugging Face, dentro del espacio de inclusionAI. Eso significa que para probarlo necesitas un entorno técnico: Python, las dependencias del repositorio y, para los modelos grandes, una GPU con memoria suficiente. Los modelos pequeños como el TTS de 0.5B son los más accesibles para empezar.
El flujo recomendado es empezar por la ficha del modelo TTS de 0.5B, leer las instrucciones de instalación y ejecutar una prueba corta. Antes de comprometerte con un flujo de trabajo completo, genera frases breves que contengan nombres propios, números y signos de puntuación, y escucha cómo los resuelve. Esa prueba rápida revela problemas de pronunciación o de ritmo que luego son más caros de corregir.
Si vas a desplegar en producción, vLLM es la vía más directa porque dio soporte a estos modelos desde el primer día. vLLM gestiona la memoria de la GPU y sirve peticiones concurrentes con buen rendimiento, algo importante cuando varias aplicaciones comparten el mismo modelo. Para el TTS de 0.5B, en cambio, puede bastar con el código de inferencia oficial en una máquina modesta.
- Empieza por el modelo pequeño
El TTS de 0.5B es el más fácil de ejecutar y el que mejor muestra las capacidades de la familia.
- Prueba frases difíciles
Nombres, cifras y puntuación compleja exponen fallos de pronunciación antes de que lleguen a producción.
- Usa vLLM para servir
Simplifica el despliegue concurrente y el aprovechamiento de GPU en entornos de producción.
- Revisa la licencia
La licencia MIT permite uso comercial, pero exige conservar el aviso de copyright y la atribución.
Comparativas, límites y para quién es
Frente a otros sistemas de voz abiertos, la propuesta de Ming-3.0 destaca por cubrir tres necesidades distintas en una sola familia: generar voz, entender audio y transcribir. Muchos proyectos abiertos se centran solo en TTS o solo en ASR, lo que obliga a combinar herramientas de proveedores diferentes. Aquí puedes unificar el stack bajo una misma licencia y un mismo ecosistema de inferencia.
La ventaja del TTS de 0.5B es su tamaño: cabe en hardware modesto y permite iterar rápido. La contrapartida es que un modelo tan pequeño puede tener menos matices expresivos que uno grande, y la calidad de la clonación depende mucho de la muestra de referencia. En cuanto a los modelos de audio y ASR, las notas no detallan cifras de precisión ni idiomas soportados, así que conviene verificar esos datos en las fichas oficiales antes de elegir.
Ming-3.0 encaja bien en equipos con conocimientos técnicos que quieran controlar sus datos y evitar depender de APIs de terceros. También es interesante para investigación en voz, doblaje y accesibilidad. Si buscas una solución lista para usar sin escribir código, esta familia todavía no ofrece una interfaz de ese tipo: tendrás que esperar a que aparezcan demos o envoltorios de la comunidad.
- Frente a TTS cerrados
Ofrece control total y ejecución local, pero exige montar tu propia infraestructura y asumir el mantenimiento.
- Frente a otros abiertos
Cubre TTS, audio y ASR en una sola familia, algo que muchos proyectos abiertos no hacen.
- Límites conocidos
No hay cifras públicas de precisión ni lista de idiomas en las notas; verifica en las fichas oficiales.
- Para quién es
Equipos técnicos, investigadores y creadores que quieran voz personalizable sin depender de servicios externos.
Guía paso a paso
Localiza los modelos en el sitio oficial
Entra en el sitio oficial de Hugging Face y busca el espacio de inclusionAI. Allí encontrarás las cinco fichas de Ming-3.0 con sus pesos, tarjetas de modelo e instrucciones. Comprueba la fecha de publicación y la licencia antes de descargar.
Prepara tu entorno
Instala Python y las dependencias que indique la ficha del modelo que elijas. Para el TTS de 0.5B basta un equipo modesto; para los modelos de 126B o 9.3B necesitarás GPU con memoria suficiente. Revisa los requisitos exactos en la documentación oficial.
Ejecuta una prueba corta
Genera una frase breve con nombres propios, números y signos de puntuación. Escucha el resultado y ajusta los parámetros de generación si el ritmo o la pronunciación no te convencen. Esta prueba te da una idea realista de la calidad antes de invertir más tiempo.
Prueba la clonación y el control por texto
Si usas el TTS de 0.5B, experimenta con una muestra de voz de referencia y con descripciones textuales de voces nuevas. Compara los resultados y anota qué tipo de instrucciones funcionan mejor. Añade risas o suspiros para comprobar el control paralingüístico.
Despliega con vLLM si vas a producción
Para servir el modelo a varias aplicaciones, usa vLLM, que dio soporte desde el primer día. Configura la memoria de GPU y prueba la concurrencia con varias peticiones simultáneas. Mide latencia y calidad antes de abrirlo a usuarios reales.
Preguntas frecuentes
¿Ming-3.0 es gratis?
Sí, los modelos se publican bajo licencia MIT, lo que permite usarlos, modificarlos y redistribuirlos sin pagar regalías, incluso con fines comerciales. Lo que sí asumes es el coste del hardware y de la electricidad necesarios para ejecutarlos. Si los usas en un producto, conserva el aviso de copyright y la atribución que exige la licencia.
¿Dónde puedo probarlo si no tengo una GPU potente?
El modelo TTS de 0.5B es el más ligero de la familia y puede ejecutarse en equipos modestos, así que es el mejor punto de partida. Los modelos grandes, como el de 126B o el de 9.3B, requieren GPU con memoria suficiente. Como todavía no hay una demo web oficial, necesitarás montar el entorno por tu cuenta siguiendo las fichas del sitio oficial.
¿Puedo clonar cualquier voz con Ming-3.0-tts?
Técnicamente el modelo puede clonar voces a partir de una muestra, pero eso no te exime de las obligaciones legales y éticas. Clonar la voz de una persona sin su consentimiento puede infringir derechos de imagen o de personalidad según el país. Usa solo voces propias o con permiso explícito, y consulta la normativa aplicable antes de publicar contenido.
¿Qué significa que un modelo sea 126B A6.5B?
Significa que el modelo tiene 126.000 millones de parámetros en total, pero solo activa alrededor de 6.500 millones por cada token que procesa. Es la arquitectura de mezcla de expertos, que reduce el coste de cómputo frente a un modelo denso del mismo tamaño. A cambio, requiere más memoria para almacenar todos los parámetros, aunque no se usen a la vez.
¿Ming-3.0 admite español y otros idiomas?
Las notas de la publicación no detallan la lista de idiomas soportados por cada modelo, así que no podemos confirmarlo. El ASR se describe como especializado en dialectos y contexto, lo que sugiere cierta amplitud, pero conviene verificarlo en las fichas oficiales. Antes de usarlo en un proyecto multilingüe, haz tus propias pruebas con textos en español.





