핵심 요약
- 앤트 그룹 inclusionAI가 MIT 라이선스로 공개한 오픈소스 음성 모델 5종 묶음으로, TTS·오디오 이해·음성 인식 세 계열을 아우릅니다.
- 0.5B TTS는 음성 복제, 텍스트 설명 기반 새 목소리 생성, 웃음·한숨 같은 부언어 표현까지 지원해 실사용 진입 장벽이 낮아요.
- 커뮤니티에서는 Artificial Analysis의 제어 가능 음성 부문 오픈소스 1위(1069 Elo)로 언급되지만 공식 벤치마크 페이지에서 직접 확인하는 게 안전해요.
- vLLM이 공개 첫날부터 지원하고 공식 추론 코드가 제공되므로, 짧은 문장 테스트 후 자체 워크플로에 붙이는 순서를 권장해요.
한눈에 보기
| 유형 | 오픈소스 음성 AI 모델 제품군 |
|---|---|
| 지원 기기 | 공식 추론 코드·vLLM 실행 환경(서버/PC급) |
| 요금 | MIT 라이선스 무료 공개, 실행 비용은 환경에 따라 다름 |
| 지원 언어 | 방언·다국어 인식 포함, 세부 목록은 공식 사이트 확인 |
| 핵심 포인트 | 0.5B TTS의 음성 복제·음성 설계·부언어 표현 |
| 난이도 | 중급, 파이썬 환경과 모델 실행 경험 필요 |
| 카테고리 | AI·모델 |
| 제작자 | Ant Ling |
| 공식 사이트 | huggingface.co ↗ |
| 화제도 | 🔥 화제도 108만 |
| 최종 업데이트 |
밍-3.0 음성 모델이 뭔가요
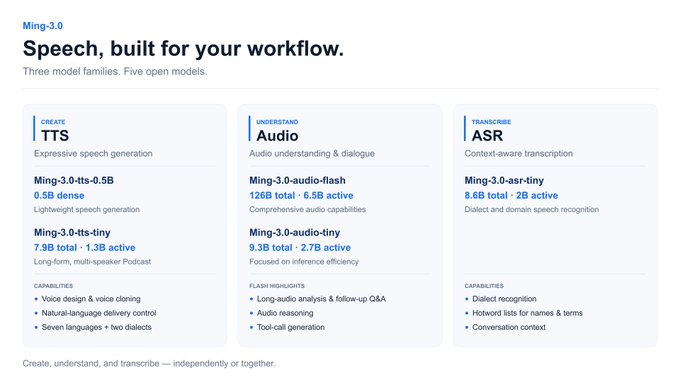
밍-3.0 음성 모델은 앤트 그룹의 inclusionAI가 2026년 10월 19일 공개한 오픈소스 음성 AI 제품군이에요. 하나의 모델이 아니라 음성 합성(TTS), 오디오 이해, 음성 인식(ASR) 세 계열에 걸친 다섯 개 모델로 구성되어 있어요. 모두 MIT 라이선스로 풀려 상업적 활용을 포함해 비교적 자유롭게 쓸 수 있는 점이 큰 특징이에요.
구성은 이렇게 나뉘어요. TTS 계열에는 0.5B 음성 설계·부언어 모델과 Tiny 7.9B A1.3B 장문 음성 모델이 있고, 오디오 이해 계열에는 Flash 126B A6.5B와 Tiny 9.3B A2.7B 대화 모델이 있어요. 마지막으로 ASR 계열에는 Tiny 8.6B A2B 방언·문맥 인식 모델이 포함돼요. 이름 뒤의 A는 활성 파라미터 규모를 뜻하는 표기로 보이지만 정확한 정의는 공식 사이트에서 확인하는 게 좋아요.
최근 이 제품군이 주목받는 이유는 0.5B TTS 모델이 음성 복제와 텍스트 설명만으로 새 목소리를 만드는 기능을 작은 크기로 해낸다는 점이에요. 커뮤니티에서는 Artificial Analysis의 제어 가능 음성 부문에서 오픈소스 1위(1069 Elo)라는 평가가 돌고 있지만, 이는 공식 발표가 아닌 커뮤니티 언급이므로 수치는 직접 확인하는 편이 안전해요.
- MIT 라이선스
다섯 모델 모두 MIT로 공개되어 상업적 사용과 수정이 허용돼요. 다만 학습 데이터 출처나 사용 지역 규제는 별도로 확인해야 해요.
- 세 계열 통합
합성·이해·인식을 한 제품군에서 다루므로 음성 파이프라인을 한 생태계 안에서 구성할 수 있어요.
- vLLM 첫날 지원
공개 당일부터 vLLM이 지원해 대규모 서빙 환경에 비교적 빠르게 올릴 수 있다는 점이 실무자에게 매력적이에요.
0.5B TTS의 음성 복제와 부언어 기능 뜯어보기
0.5B TTS 모델의 핵심은 세 가지예요. 첫째, 짧은 참조 음성을 넣으면 그 화자의 음색을 따라 하는 음성 복제 기능이에요. 둘째, 녹음 샘플 없이 '낮고 차분한 중년 남성' 같은 텍스트 설명만으로 새 목소리를 설계하는 기능이에요. 셋째, 문장 안에 웃음이나 한숨 같은 부언어 표현을 자연스럽게 섞어 넣는 기능이에요.
이 세 기능이 0.5B라는 작은 파라미터 규모에서 동작한다는 점이 실용적이에요. 모델이 가벼우면 추론 비용과 지연이 줄어들어 실시간에 가까운 응용이나 온디바이스에 준하는 환경도 노려볼 수 있어요. 다만 실제 속도와 품질은 하드웨어와 실행 설정에 따라 크게 달라지므로 자기 환경에서 직접 측정해야 해요.
장문 음성을 다룰 때는 Tiny 7.9B A1.3B 모델이 대안이 돼요. 오디오 이해와 대화형 응답이 필요하면 Flash 126B A6.5B나 Tiny 9.3B A2.7B를, 방언이나 문맥이 중요한 인식 작업에는 Tiny 8.6B A2B를 고르는 식으로 용도에 맞춰 조합하는 게 기본 전략이에요.
- 음성 복제
참조 음성을 주면 화자 특성을 따라 해요. 본인 목소리가 아닌 타인 음성 복제는 동의 문제가 생기므로 반드시 허락을 받아야 해요.
- 음성 설계
텍스트 설명으로 새 목소리를 만들어요. 설명이 구체적일수록 원하는 톤에 가까워지므로 성별·속도·감정을 함께 적는 게 좋아요.
- 부언어 표현
웃음, 한숨 같은 요소를 넣어 기계적인 낭독 느낌을 줄여줘요. 과하게 넣으면 부자연스러우니 문장당 한두 개가 적당해요.
- 모델 선택 기준
짧은 합성은 0.5B, 장문 낭독은 7.9B, 대화·이해는 126B 또는 9.3B, 방언 인식은 8.6B로 나누면 헷갈리지 않아요.
설치부터 첫 합성까지 실전 워크플로
시작점은 공식 사이트예요. huggingface.co에서 밍-3.0 모델 카드를 찾아 라이선스와 요구 환경, 제공되는 추론 코드를 먼저 읽어보세요. 모델 카드에는 각 모델의 용도와 입력 형식이 정리되어 있으니, 다섯 모델 중 무엇부터 만져볼지 여기서 결정하면 시행착오가 줄어요.
실행은 두 갈래예요. 공식 추론 코드를 그대로 돌리는 방식과 vLLM으로 서빙하는 방식이에요. 개인 테스트라면 전자가 간단하고, 여러 요청을 동시에 처리하거나 서비스에 붙일 계획이라면 vLLM 쪽이 유리해요. 어느 쪽이든 파이썬 환경과 충분한 메모리가 필요하므로 노트북보다는 GPU가 있는 환경을 권장해요.
테스트는 짧은 문장부터 시작하세요. 이름, 숫자, 문장부호가 섞인 문장을 넣으면 발음과 끊어 읽기가 제대로 되는지 빠르게 판단할 수 있어요. 여기서 만족스러우면 문단 단위 장문으로 늘리고, 마지막에 부언어 표현과 음성 설계를 얹는 순서가 효율적이에요.
- 모델 카드 우선
라이선스, 입력 형식, 권장 설정이 모두 모델 카드에 있어요. 코드를 받기 전에 먼저 읽는 습관이 문제를 절반 줄여줘요.
- 짧은 문장 검증
고유명사와 숫자가 들어간 짧은 문장으로 발음 정확도를 확인한 뒤 장문으로 넘어가세요.
- 버전 고정
오픈소스 모델은 리비전이 자주 바뀌어요. 재현성을 위해 사용한 리비전을 기록해 두면 나중에 결과 비교가 쉬워요.
비슷한 모델과 비교하면 어디에 쓰면 좋을까
오픈소스 음성 합성 시장에는 여러 선택지가 있어요. 밍-3.0의 차별점은 합성만이 아니라 인식과 오디오 이해까지 한 제품군으로 묶여 있고, 그중 작은 모델이 음성 설계와 부언어 표현을 지원한다는 점이에요. 음성 복제만 필요하다면 더 작은 전용 모델도 후보가 될 수 있고, 대화형 음성 비서를 만든다면 이해 모델까지 포함된 이 묶음이 편해요.
실제 활용처는 다양해요. 오디오북이나 안내 방송용 낭독, 게임·앱의 캐릭터 보이스, 접근성 도구의 읽어주기, 콜센터 녹취의 방언 인식과 요약 등이 대표적이에요. 특히 방언 인식 모델은 지역별 발음 편차가 큰 환경에서 유용하지만, 지원 방언 목록은 공식 사이트에서 확인해야 해요.
한계도 분명해요. 음성 복제는 동의 없는 사용, 딥페이크, 사기 같은 오남용 위험이 커서 윤리적·법적 검토가 필수예요. 또 공개된 지 얼마 되지 않아 한국어 품질이나 특정 도메인 성능에 대한 독립적 검증이 아직 부족하고, 요금이나 상업적 제약 같은 세부 조건은 바뀔 수 있으니 도입 전 공식 사이트에서 최신 정보를 확인하세요.
- 추천 사용자
음성 파이프라인을 직접 구성하려는 개발자, 콘텐츠 제작자, 접근성 도구를 만드는 팀에 잘 맞아요.
- 덜 맞는 경우
코딩 없이 바로 쓰는 완성형 서비스를 원한다면 별도 호스팅 서비스가 더 편할 수 있어요.
- 윤리적 주의
타인 음성 복제는 반드시 사전 동의를 받고, 합성 음성임을 알리는 표시를 넣는 것이 안전해요.
단계별 가이드
공식 사이트에서 모델 카드 확인하기
huggingface.co에서 밍-3.0 관련 모델 카드를 찾아 다섯 모델의 용도와 라이선스, 요구 환경을 읽어보세요. 어떤 모델이 내 작업에 맞는지 여기서 먼저 정하는 게 중요해요.
실행 환경 준비하기
파이썬 환경과 충분한 메모리를 갖춘 GPU 머신을 준비하세요. 공식 추론 코드를 쓰거나 vLLM으로 서빙하는 두 가지 방식 중 목적에 맞는 쪽을 고르면 돼요.
0.5B TTS로 짧은 문장 테스트하기
이름, 숫자, 문장부호가 들어간 짧은 문장을 합성해 발음과 끊어 읽기를 확인하세요. 여기서 문제가 없으면 문단 단위 장문으로 늘려가면 돼요.
음성 복제와 음성 설계 적용하기
참조 음성을 넣어 복제를 시험하고, 텍스트 설명으로 새 목소리도 만들어 보세요. 웃음이나 한숨 같은 부언어 표현은 문장당 한두 개만 넣어 자연스러움을 유지하세요.
워크플로에 통합하고 검증하기
만족스러운 설정을 찾았다면 사용한 모델 리비전과 파라미터를 기록하고 서비스나 앱에 연결하세요. 상업적 사용 전에는 라이선스와 데이터 출처를 다시 확인하는 게 안전해요.
자주 묻는 질문
밍-3.0 음성 모델은 무료인가요?
모델 자체는 MIT 라이선스로 무료 공개되어 상업적 사용과 수정이 가능해요. 다만 모델을 돌리기 위한 GPU 서버 비용은 사용자가 부담해야 하고, 호스팅 서비스 요금은 제공처마다 달라요. 세부 조건은 공식 사이트에서 확인하세요.
어떤 기기에서 실행할 수 있나요?
공식 추론 코드나 vLLM을 돌릴 수 있는 환경이 필요해서 일반적으로 GPU가 있는 PC나 서버급 장비를 권장해요. 0.5B 모델은 상대적으로 가볍지만 나머지 대형 모델은 메모리 요구량이 커요. 정확한 요구 사양은 모델 카드에서 확인하는 게 좋아요.
음성 복제는 어떻게 하나요?
참조할 화자의 짧은 음성을 입력으로 넣으면 모델이 그 음색을 따라 합성해요. 다만 타인의 목소리를 동의 없이 복제하면 법적·윤리적 문제가 생길 수 있으니 반드시 허락을 받아야 해요. 합성 음성임을 알리는 표시를 함께 넣는 것도 권장돼요.
한국어도 자연스럽게 지원하나요?
공개된 정보만으로는 한국어 품질을 단정하기 어려워요. 다국어와 방언 인식을 포함한다고 알려져 있지만 세부 지원 언어 목록은 공식 사이트에서 확인해야 해요. 도입 전에 한국어 문장으로 직접 테스트해 보는 것이 가장 확실해요.
커뮤니티에서 말하는 벤치마크 1위는 믿어도 되나요?
Artificial Analysis 제어 가능 음성 부문에서 오픈소스 1위라는 평가는 커뮤니티 언급으로 전해지는 내용이에요. 공식 발표가 아니므로 수치와 순위는 해당 리더보드에서 직접 확인하는 게 안전해요. 벤치마크는 평가 기준에 따라 결과가 달라질 수 있다는 점도 기억해 두세요.





