Das Wichtigste in Kürze
- Beam ist ein offenes Sprachmodell von Reflection AI mit 501B Gesamt- und 23B aktiven Parametern, veröffentlicht unter der Apache-2.0-Lizenz.
- Zum Start gibt es Gewichte in BF16, FP8 und NVFP4, dazu Tokenizer, Referenzimplementierung und einen DFlash2-Drafter für spekulatives Decoding.
- Die Mirror CLI ist das offene Trainings- und Laufzeit-Werkzeug, mit dem Beam trainiert und ausgeführt wird; Code und Anleitung liegen im offiziellen Repository auf huggingface.co.
- Für den Einstieg empfehlen sich FP8- oder NVFP4-Gewichte wegen des geringeren Speicherbedarfs, kombiniert mit dem Drafter für mehr Tempo.
Kurzüberblick
| Typ | Offenes Sprachmodell mit MoE-Architektur |
|---|---|
| Geräte | Server, Workstations, Cloud; lokal je nach Hardware |
| Kosten | Gewichte kostenlos, Apache 2.0; Infrastruktur selbst |
| Sprachen | Nicht bestätigt; Details im Model Card prüfen |
| Highlight | Vier Formate plus Drafter ab Tag eins |
| Einstieg | Repository auf huggingface.co, Mirror CLI |
| Kategorie | KI & Modelle |
| Urheber | Reflection |
| Offizielle Seite | huggingface.co ↗ |
| Trend-Index | 🔥 514,4 Tsd. Trend-Index |
| Zuletzt aktualisiert |
Was Reflection AI mit Beam veröffentlicht hat
Reflection AI hat am 16. Oktober 2026 mit Beam ein offenes Sprachmodell vorgestellt, dessen Gewichte unter der Apache-2.0-Lizenz stehen. Die Lizenz erlaubt kommerzielle und nicht-kommerzielle Nutzung, Veränderung und Weitergabe, solange die Bedingungen eingehalten werden. Damit positioniert sich Beam als Alternative zu anderen offenen Modellen, bei denen Nutzungsrechte oft eingeschränkter sind.
Das Modell hat 501 Milliarden Gesamtparameter, von denen 23 Milliarden pro Token aktiv sind. Diese Kombination deutet auf eine Mixture-of-Experts-Architektur hin, bei der nur ein Teil des Netzwerks pro Schritt rechnet. Das senkt die Rechenkosten im Betrieb, während die Gesamtkapazität hoch bleibt. Genaue Schichtdetails und Kontextlänge stehen im Model Card, das du auf der offiziellen Seite prüfen solltest.
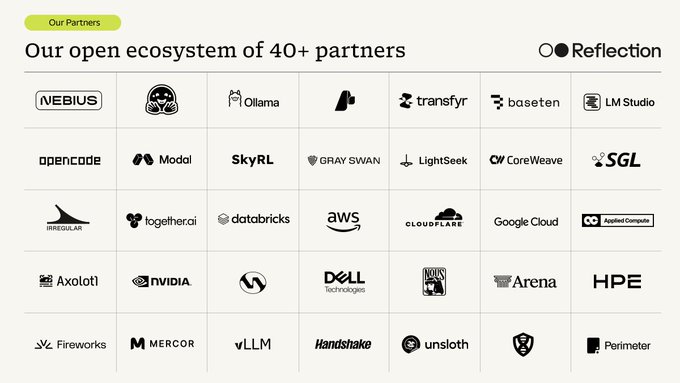
Die Veröffentlichung erfolgte zusammen mit mehr als 40 Partnern aus dem Ökosystem, die Beam zeitgleich anbieten oder integrieren. Für Nutzer bedeutet das mehr Bezugswege und Werkzeuge, aber auch, dass sich Angebote und Hosting-Optionen unterscheiden können. Wer Beam produktiv einsetzen will, sollte daher sowohl das offizielle Repository als auch die Partnerangebote vergleichen.
- Permissive Lizenz
Apache 2.0 erlaubt kommerzielle Nutzung und Weitergabe, was Beam für Firmenprojekte attraktiv macht.
- Große Gesamtkapazität
501B Parameter bieten viel Wissen, während 23B aktive Parameter die Rechenlast pro Token begrenzen.
- Breites Ökosystem
Über 40 Partner bieten Integrationen und Hosting, sodass du nicht zwingend eigene Hardware brauchst.
Gewichte, Formate und der DFlash2-Drafter im Detail
Reflection AI liefert Beam in mehreren Gewichtsformaten: BF16, FP8 und NVFP4. BF16 ist die volle Präzision und liefert die beste Qualität, braucht aber den meisten Speicher. FP8 halbiert den Speicherbedarf gegenüber BF16 und ist ein guter Kompromiss. NVFP4 ist ein 4-Bit-Format, das den Speicherbedarf weiter senkt und besonders auf neuerer NVIDIA-Hardware effizient läuft.
Zusätzlich gibt es einen DFlash2-Drafter. Ein Drafter ist ein kleines Modell, das mehrere nächste Token vorhersagt, die das große Modell anschließend in einem Durchgang prüft. Dieses spekulative Decoding kann die Ausgabegeschwindigkeit deutlich erhöhen, ohne die Qualität zu verändern, weil das Hauptmodell das letzte Wort behält. Ob der Geschwindigkeitsvorteil auf deiner Hardware greift, hängt von Speicherbandbreite und Batchgröße ab.
Ebenfalls enthalten sind Tokenizer und Referenzimplementierung. Der Tokenizer zerlegt Text in die Einheiten, die das Modell verarbeitet, und muss exakt zur jeweiligen Gewichtsversion passen. Die Referenzimplementierung zeigt, wie Beam korrekt geladen und ausgeführt wird, und dient als Vergleichsmaßstab für eigene Integrationen. Alle Dateien und Anleitungen liegen im offiziellen Repository auf huggingface.co.
- BF16 für Qualität
Nimm BF16, wenn genug Speicher vorhanden ist und du maximale Genauigkeit willst.
- FP8 als Standard
FP8 ist der beste Alltagsstart, weil es Speicher spart und die Qualität meist nahe an BF16 bleibt.
- NVFP4 für Effizienz
NVFP4 reduziert den Speicherbedarf stark, erfordert aber passende Hardware und sorgfältige Prüfung der Ausgabequalität.
- Drafter beschleunigt
Der DFlash2-Drafter kann die Token-Ausgabe beschleunigen, ohne das Ergebnis des Hauptmodells zu verändern.
Mirror CLI: Training und Betrieb von Beam
Die Mirror CLI ist das offene Werkzeug, das Reflection AI zum Training und Ausführen von Beam bereitstellt. Sie übernimmt typische Aufgaben wie das Laden von Gewichten, das Starten von Inferenz und das Verwalten von Trainingsläufen. Weil der Quellcode offen ist, kannst du nachvollziehen, welche Schritte das Team verwendet hat, und eigene Anpassungen vornehmen.
Für den produktiven Betrieb ist wichtig, dass Beam kein kleines Modell ist. Auch mit 23B aktiven Parametern brauchst du je nach Format erheblichen Speicher, und NVFP4 verlangt zusätzlich kompatible Beschleuniger. Plane deshalb zuerst die Hardware, wähle dann das Format und teste erst danach Feintuning oder längere Kontexte. So vermeidest du Fehlversuche mit unpassenden Einstellungen.
Die Mirror CLI ist auch der Ausgangspunkt für eigene Trainingsdaten und Anpassungen. Da die Lizenz permissiv ist, kannst du Beam in eigene Produkte einbetten, musst aber die Lizenzbedingungen und gegebenenfalls Hinweise im Model Card beachten. Konkrete Befehle, unterstützte Beschleuniger und Grenzwerte findest du in der Dokumentation im offiziellen Repository.
- Ein Werkzeug für alles
Die Mirror CLI bündelt Laden, Inferenz und Training, statt mehrere Skripte zu mischen.
- Hardware zuerst planen
Prüfe Speicher und Beschleuniger, bevor du ein Format wählst, sonst scheitert der Start.
- Offen für Anpassung
Der offene Code erlaubt eigene Trainingspipelines und Integrationen in bestehende Systeme.
Für wen Beam passt und wo die Grenzen liegen
Beam richtet sich an Teams und Entwickler, die ein starkes Modell selbst hosten oder anpassen wollen. Wer Datenhoheit braucht, eigene Pipelines betreibt oder Kosten langfristig kontrollieren will, profitiert von offenen Gewichten mehr als von einem reinen Cloud-Dienst. Auch Forschung und Lehre können von den nachvollziehbaren Trainingswerkzeugen profitieren.
Im Vergleich zu anderen offenen Modellen sticht Beam durch die vier Formate und den mitgelieferten Drafter ab Tag eins hervor. Das erleichtert den Einstieg, weil du nicht auf nachträgliche Quantisierungen warten musst. Andere Modelle mögen in einzelnen Benchmarks besser abschneiden oder kleinere Varianten für schwache Hardware bieten; solche Vergleiche solltest du anhand eigener Tests entscheiden, nicht anhand von Ankündigungstexten.
Zu den offenen Fragen gehören die genaue Kontextlänge, die unterstützten Sprachen und die tatsächlichen Leistungswerte. Die Quellen bestätigen diese Details nicht, deshalb solltest du sie im Model Card und in der Dokumentation auf der offiziellen Seite prüfen. Auch die Qualität nach NVFP4-Quantisierung kann je nach Aufgabe variieren, weshalb ein eigener Test mit deinen Daten unverzichtbar bleibt.
- Gut für Selbsthosting
Beam passt zu Teams, die Kontrolle über Daten und Infrastruktur behalten wollen.
- Schneller Start
Mehrere Formate und ein Drafter ersparen dir die Suche nach nachträglichen Optimierungen.
- Eigene Tests nötig
Kontextlänge, Sprachen und Benchmark-Werte sind nicht bestätigt, also selbst messen.
Schritt-für-Schritt-Anleitung
Repository und Model Card prüfen
Öffne das offizielle Repository auf huggingface.co und lies das Model Card vollständig. Dort stehen Lizenz, Formate, empfohlene Hardware und Hinweise zur Nutzung. Notiere, welche Angaben fehlen, damit du sie später gezielt testest.
Passendes Gewichtsformat wählen
Entscheide dich für BF16, FP8 oder NVFP4, abhängig von Speicher und Beschleuniger. FP8 ist meist der beste Kompromiss, NVFP4 spart am meisten Speicher. Prüfe vor dem Download, ob deine Hardware das Format unterstützt.
Mirror CLI installieren
Richte die Mirror CLI nach der Anleitung im Repository ein und lade Tokenizer sowie Gewichte. Achte darauf, dass alle Versionen zueinander passen. Ein Testlauf mit kurzer Eingabe zeigt, ob die Installation vollständig ist.
DFlash2-Drafter aktivieren
Binde den DFlash2-Drafter ein, um spekulatives Decoding zu nutzen. Miss die Ausgabegeschwindigkeit mit und ohne Drafter bei gleicher Eingabe. So erkennst du, ob sich der zusätzliche Speicherbedarf auf deiner Hardware lohnt.
Qualität mit eigenen Daten testen
Führe repräsentative Aufgaben aus deinem Anwendungsfall durch und vergleiche die Ergebnisse zwischen den Formaten. Achte auf Konsistenz, Fakten und Sprachqualität. Dokumentiere die Ergebnisse, bevor du Beam produktiv einsetzt.
Häufige Fragen
Was kostet Beam und wo bekomme ich es?
Die Gewichte von Beam sind unter der Apache-2.0-Lizenz kostenlos verfügbar; Kosten entstehen nur für Hardware, Strom oder Cloud-Hosting. Du findest Code, Gewichte und Anleitungen im offiziellen Repository auf huggingface.co. Prüfe dort die aktuellen Dateien, denn Preise und Angebote der über 40 Partner können abweichen.
Welche Hardware brauche ich für Beam?
Beam hat 501B Gesamtparameter und 23B aktive Parameter, ist also kein Modell für schwache Rechner. Mit FP8 oder NVFP4 sinkt der Speicherbedarf deutlich, NVFP4 verlangt aber passende Beschleuniger. Konkrete Mindestanforderungen und unterstützte Chips stehen in der Dokumentation im offiziellen Repository.
Was bringt der DFlash2-Drafter genau?
Der Drafter ist ein kleines Modell, das mehrere nächste Token vorhersagt, die Beam dann in einem Durchgang prüft. Dieses spekulative Decoding kann die Ausgabe beschleunigen, ohne die Qualität zu verändern, weil das Hauptmodell die endgültige Entscheidung trifft. Der tatsächliche Vorteil hängt von deiner Hardware und der Batchgröße ab.
Darf ich Beam kommerziell nutzen?
Die Apache-2.0-Lizenz erlaubt kommerzielle Nutzung, Veränderung und Weitergabe, solange die Lizenzbedingungen eingehalten werden. Du kannst Beam also in eigene Produkte einbetten. Lies trotzdem das Model Card und die Lizenzdatei, denn dort können zusätzliche Hinweise zu Herkunft oder Namensnennung stehen.
Wie unterscheidet sich Beam von anderen offenen Modellen?
Beam kommt ab Tag eins mit BF16-, FP8- und NVFP4-Gewichten sowie einem Drafter und der Mirror CLI. Das erleichtert den Start, weil du nicht auf nachträgliche Quantisierungen warten musst. Ob Beam für deine Aufgaben besser ist als andere Modelle, solltest du mit eigenen Tests und deinen Daten entscheiden.