Puntos clave
- Beam es un modelo de lenguaje de pesos abiertos creado por Reflection, con 501B parámetros totales y 23B activos, publicado bajo licencia Apache 2.0.
- Incluye pesos en BF16, FP8 y NVFP4, además de un borrador DFlash2 para decodificación especulativa y el CLI Mirror para flujos de entrenamiento.
- Puedes descargar los pesos, el tokenizador y la implementación de referencia desde el repositorio oficial en huggingface.co.
- Su licencia permisiva y la variedad de formatos lo hacen adecuado para investigación y despliegue en infraestructura propia, aunque requiere hardware potente.
Datos rápidos
| Tipo | Modelo de lenguaje de pesos abiertos |
|---|---|
| Dispositivos | Servidores y estaciones de trabajo con GPU |
| Precio | Gratuito (licencia Apache 2.0) |
| Idiomas | No especificado; consulta la model card |
| Lo destacado | 501B parámetros totales, 23B activos, varios formatos |
| Dificultad | Alta; requiere conocimientos técnicos |
| Categoría | IA y modelos |
| Creador | Reflection |
| Sitio oficial | huggingface.co ↗ |
| Popularidad | 🔥 514,4K Popularidad |
| Última actualización |
Qué es Beam y por qué Reflection lo ha liberado
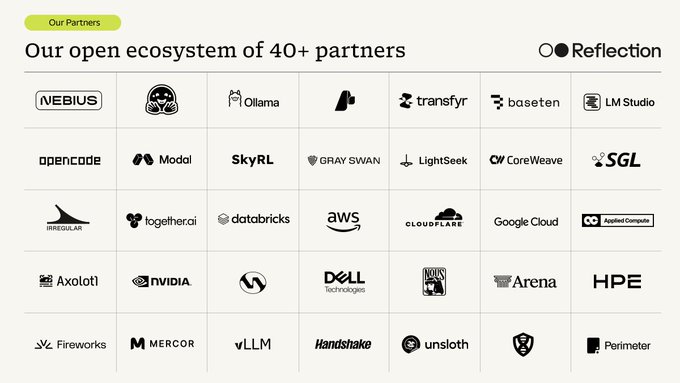
Beam es un modelo de lenguaje de gran escala desarrollado por Reflection y publicado con pesos abiertos bajo la licencia Apache 2.0. Cuenta con 501 mil millones de parámetros totales, de los cuales 23 mil millones están activos durante la inferencia, lo que sugiere una arquitectura de mezcla de expertos (MoE) que activa solo una fracción de la red para cada token. Reflection anunció su disponibilidad el 16 de octubre de 2026, en colaboración con más de 40 socios del ecosistema.
La decisión de liberar los pesos bajo Apache 2.0 es significativa porque permite uso comercial sin restricciones adicionales, algo que no todos los modelos abiertos ofrecen. Además, Reflection no solo publica los pesos, sino también el tokenizador, una implementación de referencia y las herramientas que usó para entrenar el modelo, como el CLI Mirror. Esto facilita la reproducibilidad y la experimentación por parte de la comunidad.
Beam se posiciona como una alternativa abierta frente a otros modelos propietarios y abiertos de gran tamaño. Su diseño busca equilibrar rendimiento y eficiencia: al tener solo 23B parámetros activos, puede ejecutarse en hardware más modesto que un modelo denso de 501B, aunque sigue requiriendo GPUs con suficiente memoria. La disponibilidad de múltiples formatos de cuantización refuerza esta orientación práctica.
- Licencia permisiva
Apache 2.0 permite uso comercial y modificación sin necesidad de compartir cambios, lo que facilita la adopción empresarial.
- Arquitectura eficiente
Con 23B parámetros activos de 501B totales, Beam reduce el coste computacional por token en comparación con modelos densos del mismo tamaño.
- Ecosistema de socios
Más de 40 partners han colaborado en el lanzamiento, lo que puede traducirse en integraciones y soporte en diversas plataformas.
Cómo funciona Beam: arquitectura, formatos y decodificación especulativa
Beam utiliza una arquitectura de mezcla de expertos (MoE), aunque Reflection no ha detallado públicamente la configuración exacta de expertos ni la longitud de contexto. Lo que sí se sabe es que el modelo se distribuye en tres formatos de pesos: BF16, FP8 y NVFP4. BF16 ofrece la mayor precisión numérica, mientras que FP8 y NVFP4 reducen el uso de memoria y aceleran la inferencia en hardware compatible, a costa de una posible pérdida mínima de calidad.
Junto con los pesos, Reflection incluye un borrador DFlash2, un modelo auxiliar más pequeño que permite decodificación especulativa. Esta técnica consiste en que el borrador propone varios tokens y el modelo principal los verifica en paralelo, lo que puede aumentar la velocidad de generación sin cambiar el resultado final. Es una práctica habitual en modelos grandes para mejorar la latencia en producción.
El CLI Mirror es la herramienta de código abierto que Reflection usó para entrenar Beam. Aunque no se han publicado todos los detalles del proceso de entrenamiento, la disponibilidad de Mirror permite a investigadores reproducir flujos de trabajo similares o adaptarlos a sus propios modelos. La implementación de referencia y el tokenizador también están disponibles en el repositorio oficial en huggingface.co.
- Elige el formato adecuado
Para menor uso de memoria, empieza con FP8 o NVFP4; si necesitas máxima fidelidad, usa BF16, aunque requerirá más VRAM.
- Aprovecha el borrador DFlash2
Combínalo con los pesos principales para acelerar la inferencia en tareas de generación de texto largo.
- Explora Mirror CLI
Úsalo para entender el proceso de entrenamiento o para adaptar flujos de trabajo a tus propios datos.
Cómo empezar a usar Beam desde el repositorio oficial
Para probar Beam, el primer paso es acceder al repositorio oficial en huggingface.co. Allí encontrarás los pesos en los tres formatos, el tokenizador, la implementación de referencia y el CLI Mirror. Reflection no ha publicado una demo interactiva ni una API alojada, por lo que necesitarás descargar los archivos y ejecutarlos en tu propio hardware o en un entorno en la nube con GPUs adecuadas.
Antes de descargar, revisa la model card para conocer los requisitos de hardware y las instrucciones de uso. Dado que el modelo tiene 501B parámetros totales, incluso en FP8 o NVFP4 necesitarás una cantidad considerable de memoria GPU. Para pruebas iniciales, puedes considerar usar una instancia en la nube con múltiples GPUs o probar con los pesos cuantizados en un entorno con suficiente VRAM.
Una vez descargados los pesos, sigue las instrucciones del repositorio para cargar el modelo con la implementación de referencia. Si deseas acelerar la inferencia, integra el borrador DFlash2 según la documentación. Para flujos de entrenamiento o ajuste fino, el CLI Mirror ofrece comandos que puedes adaptar. Recuerda que, al ser un modelo abierto, la comunidad puede publicar guías adicionales, pero verifica siempre la información en el repositorio oficial.
- Verifica los requisitos
Consulta la model card para conocer la memoria GPU necesaria según el formato de pesos que elijas.
- Empieza con FP8 o NVFP4
Estos formatos reducen el uso de memoria y son más prácticos para pruebas iniciales en hardware limitado.
- Sigue las instrucciones oficiales
La implementación de referencia y el CLI Mirror incluyen documentación para cargar el modelo y ejecutar tareas.
Casos de uso, comparaciones y limitaciones de Beam
Beam está pensado para organizaciones y desarrolladores que necesitan un modelo de lenguaje potente y quieren controlar su despliegue. Al ser de pesos abiertos, permite ajuste fino, implementación en infraestructura propia y adaptación a dominios específicos. Es útil para investigación, generación de texto, análisis de documentos y asistentes conversacionales, siempre que se cuente con los recursos computacionales necesarios.
En comparación con otros modelos abiertos de gran tamaño, como Llama o Mistral, Beam se distingue por su licencia Apache 2.0 y por incluir múltiples formatos de cuantización y un borrador especulativo desde el lanzamiento. Sin embargo, no se han publicado resultados de benchmarks que permitan comparar su rendimiento objetivamente con esos modelos. Reflection tampoco ha detallado la longitud de contexto ni los idiomas soportados, por lo que conviene consultar la model card actualizada.
Una limitación importante es el hardware requerido: aunque los 23B parámetros activos reducen la carga, los 501B totales implican que los pesos completos ocupan mucho espacio, incluso cuantizados. Además, al no haber una API oficial, la latencia y el coste dependerán de tu infraestructura. Para quienes buscan una solución lista para usar sin gestionar servidores, puede ser más práctico optar por modelos con API alojada, aunque Beam ofrece mayor control y transparencia.
- Ideal para investigación y desarrollo
La licencia permisiva y las herramientas abiertas facilitan la experimentación y la personalización.
- Comparación con modelos propietarios
Beam no tiene una API oficial, por lo que requiere autogestión; a cambio, ofrece control total sobre los datos y el despliegue.
- Limitaciones de hardware
Necesitarás GPUs con amplia memoria; los formatos cuantizados ayudan, pero no eliminan el requisito de infraestructura potente.
Guía paso a paso
Accede al repositorio oficial
Dirígete a huggingface.co y busca el repositorio de Reflection para Beam. Allí encontrarás los pesos, el tokenizador y la documentación. Verifica que la licencia Apache 2.0 se ajuste a tu caso de uso.
Revisa la model card y los requisitos
Lee la model card para conocer los formatos disponibles, los requisitos de hardware y las instrucciones de carga. Presta atención a la memoria GPU necesaria según el formato (BF16, FP8 o NVFP4).
Descarga los pesos y el tokenizador
Elige el formato que mejor se adapte a tu hardware. Si tienes poca memoria, opta por FP8 o NVFP4. Descarga también el tokenizador y la implementación de referencia para poder ejecutar el modelo.
Configura el entorno y carga el modelo
Sigue las instrucciones del repositorio para instalar las dependencias y cargar el modelo con la implementación de referencia. Si deseas acelerar la inferencia, integra el borrador DFlash2 según la documentación.
Ejecuta pruebas y ajusta
Realiza pruebas con tus propios prompts para evaluar el rendimiento y la calidad. Si necesitas entrenar o ajustar el modelo, utiliza el CLI Mirror siguiendo las guías del repositorio. Ajusta los parámetros según tus objetivos.
Preguntas frecuentes
¿Beam es gratuito?
Sí, Beam se distribuye bajo la licencia Apache 2.0, lo que permite su uso gratuito, incluido el uso comercial, siempre que se cumplan los términos de la licencia. No obstante, deberás asumir los costes del hardware o de la infraestructura en la nube necesarios para ejecutarlo. Reflection no ofrece una API de pago ni un servicio alojado, por lo que el coste depende de tu despliegue.
¿En qué dispositivos puedo ejecutar Beam?
Beam está diseñado para ejecutarse en servidores o estaciones de trabajo con GPUs de alta capacidad. No es un modelo que puedas correr en un teléfono móvil o en una laptop convencional. Los formatos FP8 y NVFP4 reducen los requisitos de memoria, pero aún necesitarás una GPU con suficiente VRAM. Consulta la model card para conocer los requisitos exactos.
¿Cómo funciona la decodificación especulativa con DFlash2?
DFlash2 es un modelo borrador más pequeño que propone varios tokens candidatos. El modelo principal Beam verifica esos tokens en paralelo y acepta los que coinciden con su propia predicción. Este proceso acelera la generación porque permite avanzar varios tokens por paso, manteniendo la calidad del resultado final. Es una técnica estándar en modelos grandes para reducir la latencia.
¿Beam está disponible en español?
Reflection no ha especificado los idiomas soportados en la información disponible. Para saber si Beam funciona bien en español, consulta la model card actualizada o realiza tus propias pruebas. Dado que es un modelo abierto, la comunidad puede compartir evaluaciones. Si el soporte de idiomas es crítico para tu proyecto, verifica este punto antes de adoptarlo.
¿Qué diferencia a Beam de otros modelos abiertos?
Beam se distingue por su licencia Apache 2.0, que es más permisiva que algunas licencias de modelos abiertos, y por incluir desde el primer día pesos en BF16, FP8 y NVFP4, además de un borrador DFlash2 y el CLI Mirror. Sin embargo, no se han publicado benchmarks que permitan comparar su rendimiento con otros modelos. Su arquitectura MoE con 23B parámetros activos también busca un equilibrio entre potencia y eficiencia.