要点まとめ
- Reflection AIがApache 2.0で公開したオープンウェイトモデルで、501B総パラメータ・23BアクティブのMoE構成を採用しています。
- BF16・FP8・NVFP4の3種類の量子化重みと、投機的デコード用のDFlash2ドラフターが初日から揃っています。
- 学習に使われたオープンソースのハーネスMirror CLIも同時に公開され、再現実験やファインチューニングに利用できます。
- モデル本体は無料ですが、実際に動かすには相応のGPUメモリが必要で、量子化形式の選択が実用性を左右します。
基本情報
| ジャンル・位置づけ | オープンウェイトの大規模言語モデル |
|---|---|
| 対応端末 | GPUサーバーやクラウド環境(公式リポジトリ参照) |
| 料金 | 重みは無料公開、利用環境のコストは別途 |
| 対応言語 | 公式モデルカードで確認してください |
| 注目ポイント | Apache 2.0、3種の量子化重みとドラフターを同時提供 |
| 難易度 | 中〜上級(GPU環境とコマンド操作が必要) |
| カテゴリ | AI・新モデル |
| 作者・提供元 | Reflection |
| 公式サイト | huggingface.co ↗ |
| 注目度 | 🔥 注目度 51万 |
| 最終更新 |
Beamオープンモデルとは何か:Reflection AIが放つ501Bの巨躯
Beamは、Reflection AIが2026年10月16日に公開したオープンウェイトの大規模言語モデルです。最大の特徴は501Bという総パラメータ数で、推論時にはそのうち23Bのみを活性化するMixture-of-Experts(MoE)型のアーキテクチャを採用しています。巨額の計算資源を要する密なモデルとは異なり、必要な計算量を抑えつつ大規模な知識容量を確保できる設計です。
ライセンスはApache 2.0で、商用利用を含めてかなり自由に扱えます。しかも重みだけでなく、トークナイザー、参照実装、学習に使われたハーネスまで一式が公開されている点が異例です。研究目的だけでなく、自社サービスへの組み込みやファインチューニングの土台としても現実的な選択肢になります。
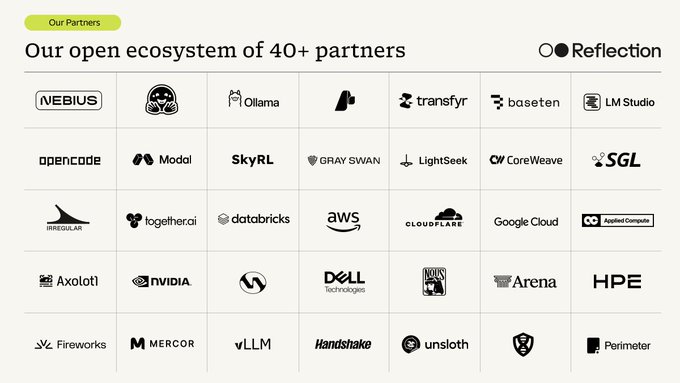
公開は単独ではなく、40社以上のパートナーと連携して行われました。モデル配布の窓口はHugging Face上の公式リポジトリで、そこに重みとモデルカード、利用手順がまとまっています。オープンモデルでありながらエコシステム全体での提供という点が、今回の発表の大きな特徴です。
- 501B総パラメータ・23Bアクティブ
総パラメータは501Bと非常に大きい一方、推論時に動くのは23B分のみです。この差が実用上のメモリと速度に直結します。
- Apache 2.0ライセンス
商用利用や改変、再配布がしやすい寛容なライセンスです。詳細な条件は公式リポジトリのライセンス表記を確認してください。
- 40社以上のパートナー連携
公開時点で多数のパートナーが同時に展開しており、利用環境やツールの選択肢が広がっています。
配布物の中身:BF16・FP8・NVFP4の重みとDFlash2ドラフター
Beamの公開物で特に目を引くのが、量子化形式の豊富さです。BF16、FP8、NVFP4という3種類の重みが初日から用意されており、GPUのメモリ容量や求める精度に応じて選べます。BF16は精度重視、FP8やNVFP4はメモリ節約と速度重視という位置づけで、同じモデルを環境に合わせて使い分けられるのは実用上大きな利点です。
さらにDFlash2と呼ばれるドラフターモデルも同梱されています。これは投機的デコード(speculative decoding)を高速化するための補助モデルで、小さなモデルが複数トークンを先読みし、本体がそれをまとめて検証する仕組みです。出力の品質を保ちながら生成速度を引き上げられるため、対話用途や長文生成で効果が期待できます。
学習用のハーネスであるMirror CLIもオープンソースで公開されました。これはBeamの学習に実際に使われたツールで、再現実験やファインチューニングのワークフローを自分で組む際の出発点になります。推論用の重みと学習用ツールがセットで提供される点は、オープンモデルの中でも特に充実した構成です。
- BF16:精度重視の基準形式
最も精度を保ちやすい形式ですが、その分メモリ消費は大きくなります。まずはこの形式で挙動を確認するのが基本です。
- FP8・NVFP4:メモリ節約向け
量子化によって省メモリ・高速化が期待できます。対応するGPUアーキテクチャかどうかを事前に確認してください。
- DFlash2ドラフター
投機的デコードを支援する補助モデルです。本体と組み合わせることで生成速度の向上が見込めます。
- Mirror CLI
Beamの学習に使われたオープンソースのハーネスです。学習や微調整のワークフロー構築に役立ちます。
Beamの使い方:Hugging Faceから重みを取得して動かすまで
利用の第一歩は、Hugging Face上の公式リポジトリから重みとモデルカードを取得することです。モデルカードには推論手順や必要環境の情報がまとまっているので、まずはそこを一読してください。重みはサイズが大きいため、ストレージとダウンロード帯域を事前に確保しておくことが重要です。
次に、手持ちのGPUメモリに合わせて量子化形式を選びます。余裕があればBF16、厳しければFP8やNVFP4といった具合です。そのうえで参照実装またはMirror CLIの手順に従って推論環境を構築します。DFlash2ドラフターを使う場合は、本体モデルとの組み合わせ設定が必要になるため、モデルカードの指示に従ってください。
運用面では、投機的デコードの有効化によってレイテンシが変わる点を実測しておくとよいでしょう。また、Apache 2.0であっても再配布時にはライセンス表記の保持が必要です。商用利用を検討する場合は、公式リポジトリのライセンス条文とモデルカードの注意事項を必ず確認してください。
- まずはモデルカードを読む
推論手順や必要環境、既知の制限はモデルカードに集約されています。最初に目を通すことで遠回りを避けられます。
- 環境に合った量子化を選ぶ
GPUメモリが十分ならBF16、足りなければFP8やNVFP4を検討します。対応アーキテクチャかどうかも確認しましょう。
- 速度は実測で確認
ドラフターの有無や量子化形式によってスループットは変わります。自分の用途でベンチマークを取るのが確実です。
類似モデルとの比較と、Beamが向く人・向かない人
Beamの立ち位置は、大規模なオープンウェイトモデルの中でも「公開初日から実用装備が揃っている」点にあります。多くのモデルは重みのみの公開から始まり、量子化版や高速化用のドラフターは後からコミュニティによって整備されることが少なくありません。BeamはBF16・FP8・NVFP4とDFlash2ドラフターを同時に提供することで、利用者がすぐ試せる状態を作っています。
一方で、501Bという総パラメータ数は伊達ではなく、ローカル環境で気軽に動かせる規模ではありません。FP8やNVFP4を選んでも相応のGPUメモリが必要で、個人のデスクトップで扱うには限界があります。クラウドGPUや複数GPUを用意できるチーム向けのモデルと考えるのが現実的です。
向いているのは、自社データでのファインチューニングを検討している開発チームや、推論基盤を自前で構築したい企業です。Apache 2.0とMirror CLIの存在は、学習プロセスまで踏み込みたい組織にとって大きな魅力です。逆に、手軽にチャットを試したいだけの個人には、より小規模なモデルやホスト型サービスのほうが適しています。
- 公開初日から装備が揃う
量子化重みとドラフターが同時に提供されるため、後から整備されるのを待たずに検証を始められます。
- 学習まで開かれている
Mirror CLIが公開されているため、推論だけでなく学習や微調整の再現にも取り組めます。
- 個人利用には敷居が高い
モデルサイズが大きく、実用的に動かすにはクラウドGPUなどの計算資源が必要です。
ステップ別ガイド
公式リポジトリを確認する
Hugging Face上のReflection AIの公式リポジトリを開き、モデルカードとライセンス表記を読みます。必要環境や推論手順の最新情報はここに集約されています。
量子化形式を選ぶ
手持ちのGPUメモリと求める精度に応じて、BF16・FP8・NVFP4から選びます。迷ったらまずBF16で動作確認し、足りなければ軽い形式に切り替えるのが安全です。
重みとトークナイザーを取得する
選んだ重み、トークナイザー、参照実装をダウンロードします。ファイルサイズが大きいため、ストレージと回線に余裕を持たせてください。
推論環境を構築する
参照実装またはMirror CLIの手順に従って環境をセットアップします。DFlash2ドラフターを使う場合は、モデルカードの指示に従って本体と組み合わせます。
速度と品質を検証する
実際のプロンプトで生成速度と出力品質を確認します。ドラフターの有無や量子化形式を変えながら、自分の用途に合う構成を決めていきましょう。
よくある質問
Beamは無料で使えますか?
重みはApache 2.0ライセンスで無料公開されており、商用利用も可能とされています。ただしモデルを動かすためのGPUやクラウド利用料は別途かかります。ライセンスの詳細な条件は公式リポジトリで確認してください。
個人のPCでも動きますか?
501B総パラメータ・23Bアクティブという規模のため、一般的な個人向けPCでの動作は現実的ではありません。FP8やNVFP4の量子化重みを使っても相応のGPUメモリが必要です。クラウドGPUや複数GPU環境の利用を検討してください。
DFlash2ドラフターとは何ですか?
投機的デコードを支援する補助モデルで、小さなモデルが複数トークンを先読みし、本体がまとめて検証する仕組みです。これにより出力品質を保ちながら生成を高速化できます。設定方法はモデルカードの指示に従ってください。
Mirror CLIは何に使えますか?
Beamの学習に実際に使われたオープンソースのハーネスで、学習やファインチューニングのワークフロー構築に利用できます。再現実験や独自データでの微調整をしたい開発者向けのツールです。詳しい使い方は公式リポジトリの手順を参照してください。
商用利用に制限はありますか?
Apache 2.0ライセンスのもとで公開されているため、商用利用を含めて比較的自由に扱えるとされています。ただし再配布時のライセンス表記の保持など条件があります。実際の利用前に公式リポジトリのライセンス条文を必ず確認してください。