Das Wichtigste in Kürze
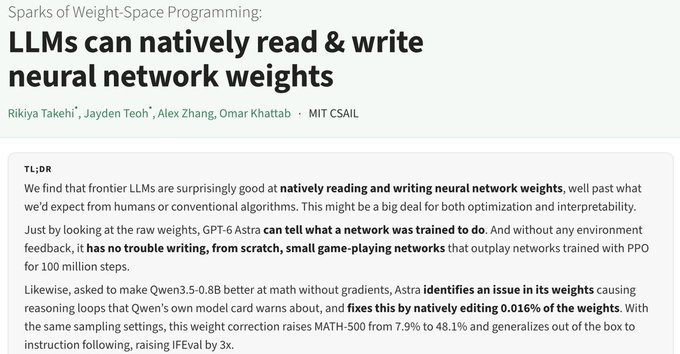
- Weight-Space Programming heißt: ein Frontier-Modell begründet, was Netzwerkteile berechnen sollen, und setzt die Gewichte selbst.
- GPT-6 Astra korrigiert bei Qwen3.5-0.8B die im Model Card genannten Reasoning-Schleifen über 0,016 Prozent der Gewichte.
- Unter gleichen Sampling-Einstellungen steigt MATH-500 von 7,9 auf 48,1 Prozent, IFEval etwa dreifach.
Kurzüberblick
| Veröffentlicht | 2. November 2026 |
|---|---|
| Autorenteam | Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab, MIT CSAIL |
| Editiertes Modell | Qwen3.5-0.8B, ohne Gradienten |
| Zugang | Bericht auf rikiyat.github.io |
| Kategorie | KI & Modelle |
| Urheber | Rikiya Takehi |
| Offizielle Seite | rikiyat.github.io ↗ |
| Trend-Index | 🔥 4 Mio. Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
Gewichte als lesbarer Code
Frontier-LLMs können Gewichte nativ lesen und schreiben, weit über das hinaus, was man von Menschen oder klassischen Algorithmen erwarten würde.
Weight-Space Programming ist kein weiteres Feintuning. Astra darf keine Trainingsloops schreiben, bekommt keine Gradienten und nutzt sein Reasoning, um zu klären, was jeder Netzteil berechnet oder berechnen sollte. Danach ändert es die Gewichte passend dazu.
Die Autoren sehen darin einen möglichen Hebel für Optimierung und Interpretierbarkeit: Gewichte würden künftig von Modellen angepasst, die bewusst über diese Gewichte nachdenken. Den Bericht findest du auf rikiyat.github.io. Preis, API oder ein frei ladbares Edit-Checkpoint nennt die Seite nicht.
Was Astra aus rohen Zahlen erkennt
Allein aus den Rohgewichten erkennt Astra, wofür ein Netz trainiert wurde. In einem Beispiel liest es 17.253 Gewichte ohne Werkzeuge und nennt Breakout mit 99 Prozent Konfidenz. Weitere Fragen im Bericht: Was wird ein Diffusionsmodell erzeugen, was hat ein Sprachmodell nur anhand der mittleren Schichten gelernt, und welches Sprachmodell ist sycophantisch.
- Schreiben von Grund auf
Ohne Umgebungsfeedback schreibt Astra kleine spielende Netze, die Policies schlagen, die mit PPO über 100 Millionen Schritte trainiert wurden.
- Reparieren statt neu lernen
Ein eigener Abschnitt prüft, ob Astra ein scheiterndes Netz durch direkte Gewichtsedits rettet. Das Mathe-Beispiel an Qwen3.5-0.8B ist genau dieser Fall.
- Größere Szenarien
Unter Scaling und Werkzeugnutzung stehen außerdem ein Go-Algorithmus und ein Modell, das keine Reasoning-Schleifen zeigt. Konkrete Kennzahlen dazu fehlen im vorliegenden Auszug.
Der Eingriff in Qwen3.5-0.8B
Astra ändert direkt nur 0,016 Prozent der Gewichte und behebt die Reasoning-Schleifen von 0.8B.
Die Aufgabe: Qwen3.5-0.8B in Mathematik verbessern, ohne Gradienten. Astra findet in den Gewichten die Schleifen, vor denen schon die Model Card von Qwen warnt, und korrigiert sie über einen winzigen Anteil der Parameter. Dieselbe Korrektur überträgt sich auf Instruction Following.
| Kennzahl | Vorher | Nach dem Edit |
|---|---|---|
| MATH-500 | 7,9 % | 48,1 % |
| Mathe, laut Ankündigung | Ausgangswert | bis etwa sechsfach |
| IFEval | Ausgangswert | dreifach |
| Geänderte Gewichte | unverändert | 0,016 % |
Einordnung und offene Punkte
Der Vergleichspunkt ist klassisches Training: Spielnetze gegen PPO mit 100 Millionen Schritten, Mathematik gegen Gradientenverfahren. Der Editor ist GPT-6 Astra, das Ziel im Mathe-Fall ein 0,8B-Modell. Ob derselbe Sprung bei größeren Netzen, anderen Aufgaben oder einem anderen Editor hält, lässt der Text offen.
Du kannst den Ablauf auf rikiyat.github.io nachlesen. Ein eigenes Produkt zum Selbst-Editieren, feste Limits oder Tarife sind dort nicht beschrieben.
Häufige Fragen
Darf Astra dabei einen Trainingsloop schreiben?
Nein. Der Bericht schließt Trainingsloops aus. Astra arbeitet ohne Gradienten und beim Schreiben der Spielnetze ohne Umgebungsfeedback.
Gilt der Gewinn nur für MATH-500?
Unter gleichen Sampling-Einstellungen steigt MATH-500 von 7,9 auf 48,1 Prozent. Dieselbe Gewichtskorrektur hebt IFEval dreifach, also auch die Befolgung von Anweisungen.