一分钟看懂
- 权重空间编程指前沿大模型直接读、写神经网络权重,而不是去写训练循环。
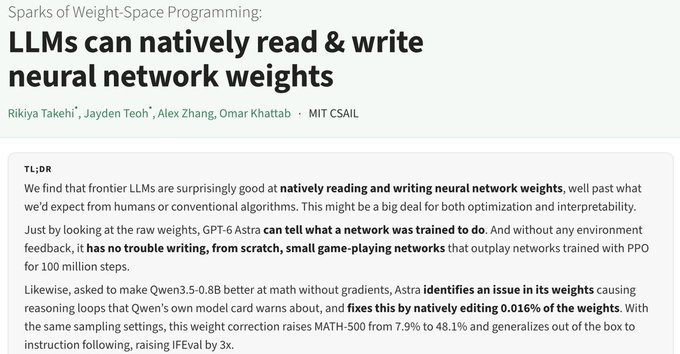
- GPT-6 Astra只改Qwen3.5-0.8B约0.016%的权重,MATH-500从7.9%升至48.1%,指令遵循约提升至原来的3倍。
- 公开材料是rikiyat.github.io上的研究页面,目前未见单独的产品定价或可调用接口说明。
基本信息
| 发布日期 | 2026年11月2日 |
|---|---|
| 作者与机构 | Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab,麻省理工学院CSAIL |
| 核心改动 | Qwen3.5-0.8B权重的0.016% |
| 数学成绩 | MATH-500由7.9%升至48.1% |
| 分类 | AI 前沿 |
| 作者 / 发布方 | Rikiya Takehi |
| 官方入口 | rikiyat.github.io ↗ |
| 热度 | 🔥 热度 401万 |
| 发布时间 | |
| 数据更新 |
直接在权重上编程
前沿大模型出人意料地擅长直接阅读和书写神经网络权重,超出人们对人类或常规算法的预期。
页面题为《Sparks of Weight-Space Programming》。作者认为,这同时关系到优化与可解释性:模型靠推理判断网络每一部分在计算什么、应当计算什么,再据此改权重。实验设定里,Astra不得编写训练循环。
他们把这种方法称为权重空间编程,并写道:神经网络权重很快会由能够认真推理这些权重的大模型来做原生优化。入口在rikiyat.github.io。
只看参数就能读懂行为
只看原始权重,GPT-6 Astra就能判断一个网络被训练来做什么。
在一项读权重测试中,Astra不使用工具,直接阅读17253个权重,并以99%的把握判断该网络对应游戏Breakout。页面还探讨扩散模型将生成什么、只看语言模型网络中部能否判断它学到了什么,以及哪一个语言模型更会迎合用户。这些小节在公开摘录里没有给出可引用的数字结果。
写权重方面,Astra在没有环境反馈时,能从零写出小型游戏策略网络,并胜过用PPO训练1亿步得到的网络。页面同时讨论修复失效网络、编写围棋算法,以及在不会陷入循环的模型上继续提高数学能力。
| 实验 | 公开摘录中的结果 |
|---|---|
| 识别训练游戏 | 无工具阅读17253个权重,对Breakout把握99% |
| 从零编写策略网络 | 无环境反馈,胜过PPO训练1亿步的网络 |
| 改进0.8B数学 | 改动0.016%权重,MATH-500从7.9%到48.1% |
几乎不改参数就抬高数学
它直接改动约0.016%的权重,修正推理循环,数学能力最多提升约6倍,指令遵循约提升至原来的3倍。
具体任务是让Qwen3.5-0.8B更擅长数学,且不使用梯度。Astra在权重里定位到导致推理循环的问题,而Qwen自己的模型卡已提醒过这类循环,随后只编辑0.016%的权重。
同一套采样设置下,MATH-500从7.9%升到48.1%,约相当于原来的6倍。该修正还直接泛化到指令遵循,IFEval约提升至原来的3倍。摘录没有给出IFEval的绝对分数,也没有公布改写后权重的下载方式或接口价格。
- 改动比例
相对整个Qwen3.5-0.8B,被直接改写的权重约占0.016%。
- 数学
MATH-500由7.9%升至48.1%。
- 指令遵循
IFEval约提升至原来的3倍,绝对分未在摘录中给出。
- 方法边界
不写训练循环,不靠梯度,靠对计算角色的推理来改权重。
常见问题
改写后的Qwen3.5-0.8B权重可以下载或调用吗?
目前公开的是rikiyat.github.io上的研究页。摘录没有说明改写后的权重、应用程序或付费接口已经放出。
6倍是指哪一项指标?
作者说数学最多提升约6倍。页内对应数字是同一采样设置下MATH-500从7.9%升至48.1%;指令遵循则是IFEval约3倍。