Puntos clave
- Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab (MIT CSAIL) llaman programación en el espacio de pesos a que un modelo de frontera lea y escriba pesos con razonamiento, sin bucles de entrenamiento.
- GPT-6 Astra editó el 0,016% de Qwen3.5-0.8B, subió MATH-500 del 7,9% al 48,1% con el mismo muestreo y multiplicó IFEval por tres.
- El relato público está en rikiyat.github.io, con fecha 2 de noviembre de 2026; no se describe una API ni una tarifa.
Datos rápidos
| Publicado | 2 de noviembre de 2026 |
|---|---|
| Autores | Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab (MIT CSAIL) |
| Modelo que edita | GPT-6 Astra, sin gradientes ni bucles de entrenamiento |
| Dónde leerlo | rikiyat.github.io |
| Categoría | IA y modelos |
| Creador | Rikiya Takehi |
| Sitio oficial | rikiyat.github.io ↗ |
| Popularidad | 🔥 4M Popularidad |
| Publicado | |
| Última actualización |
Programar la red mirando sus pesos
Los modelos de frontera leen y escriben pesos neuronales mucho mejor de lo que cabría esperar de una persona o de un algoritmo convencional.
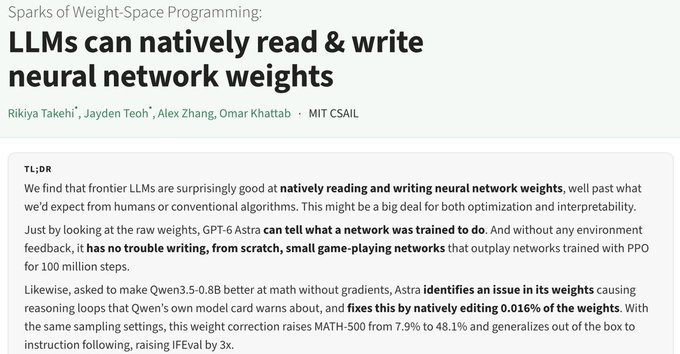
Programación en el espacio de pesos (Weight-Space Programming) es el nombre que dan Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, los cuatro en MIT CSAIL, a una capacidad que describen en el texto Sparks of Weight-Space Programming, fechado el 2 de noviembre de 2026. La idea es directa: un modelo de frontera mira los pesos en bruto, razona qué calcula cada parte de la red o qué debería calcular, y los cambia. No se le permite escribir bucles de entrenamiento.
El resumen lo presenta como algo relevante a la vez para la optimización y para la interpretabilidad. La frase de cierre apunta a un cambio de método: los pesos pasarían a optimizarse de forma nativa por modelos que razonan sobre ellos a propósito. Puedes leer el informe en rikiyat.github.io. Ahí está el material público; no se detalla una aplicación, una API ni un precio.
Leer una red y decir para qué sirve
Solo con los pesos en bruto, GPT-6 Astra puede decir para qué se entrenó una red.
En la prueba más concreta de lectura, Astra examina 17.253 pesos, sin herramientas, y señala que la red se entrenó en Breakout con un 99% de confianza. El argumento del informe es que esa lectura supera lo que se esperaría de una persona o de un algoritmo convencional mirando la misma matriz.
La página también plantea si Astra anticipa lo que va a generar un modelo de difusión y si puede decir qué aprendió un modelo de lenguaje usando solo la parte media de la red. Esas preguntas forman parte del apartado de lectura. El resultado con cifra cerrada en el resumen es el de Breakout.
Escribir desde cero y reparar Qwen3.5-0.8B
Astra cambió solo el 0,016% de los pesos, arregló los bucles de razonamiento y mejoró las matemáticas cerca de seis veces, y el seguimiento de instrucciones por tres, sin gradientes ni entrenamiento.
Sin retroalimentación del entorno, Astra escribe desde cero redes pequeñas para jugar que superan a políticas entrenadas con PPO durante 100 millones de pasos. En lenguaje, la tarea fue hacer mejor en matemáticas a Qwen3.5-0.8B sin gradientes. Astra localizó en los pesos un fallo de bucles de razonamiento del que ya advierte la ficha del propio Qwen y lo corrigió editando de forma nativa el 0,016% de los pesos.
Con la misma configuración de muestreo, MATH-500 pasa del 7,9% al 48,1%. El arreglo se generaliza solo al seguimiento de instrucciones y multiplica IFEval por tres. El informe subraya que nada de esto depende de dejar que Astra programe un entrenamiento.
| Medida | Antes | Después |
|---|---|---|
| Pesos modificados | Sin edición | 0,016% |
| MATH-500 | 7,9% | 48,1% |
| IFEval | Referencia del modelo | El triple |
Para qué sirve y qué deja abierto
Puede ser un asunto importante tanto para la optimización como para la interpretabilidad.
El uso que el propio texto deja más claro es de diagnóstico y de corrección mínima: un modelo fuerte lee otro más pequeño, reconoce un fallo ya descrito y lo toca en una fracción diminuta de pesos. El otro es de diseño directo, con redes de juego pequeñas que compiten contra un entrenamiento muy largo de PPO.
El informe habla de chispas y abre escenarios más cercanos al uso real: escalar, usar herramientas, escribir un algoritmo de Go, distinguir qué modelo de lenguaje es adulador y subir las matemáticas de un modelo que no entra en bucles. Esos apartados están en la página; el resumen no fija una cifra para cada uno. Sigue abierta la pregunta de hasta dónde llega esta programación cuando la red ya no es pequeña o cuando el fallo no viene descrito en una ficha técnica.
- Optimización sin bucle
El modelo editor razona sobre lo que cada bloque debería calcular y reescribe pesos, en lugar de lanzar un entrenamiento.
- Interpretabilidad práctica
La lectura de pesos en bruto sirve para decir la tarea de una red, como en el caso de Breakout, y para localizar un defecto ya advertido por Qwen.
- Alcance aún por medir
Go, la adulación entre modelos y la mejora de un modelo que no entra en bucles aparecen como líneas del informe, sin números cerrados en el resumen.
Preguntas frecuentes
¿Hizo falta entrenar Qwen3.5-0.8B para subir MATH-500?
No. Astra editó de forma nativa el 0,016% de los pesos, sin gradientes y sin permiso para escribir bucles de entrenamiento. Con el mismo muestreo, MATH-500 pasó del 7,9% al 48,1%.
¿Hay API o pesos editados para descargar?
El material que se indica es la página del informe en rikiyat.github.io, publicada el 2 de noviembre de 2026. No se describe una API, una tarifa ni una liberación de pesos.