Puntos clave
- Seis modelos de pesos abiertos en torno a los 2.000 millones de parámetros construidos sobre la misma base LFM3-1.7B-Base.
- Arquitectura trihíbrida optimizada para 14 clases de procesadores en GPU, CPU y NPU, con ajuste fino (fine-tuning) en una sola GPU.
- LFM3-1.7B ofrece 256K de contexto para miles de agentes en paralelo y LFM3-VL-2B (1,9B) admite vídeo compitiendo con Gemma 4 12B y Gemini 3.5 Flash Lite.
- Pesos disponibles en Hugging Face en GGUF, ONNX, Apple MLX, FP8 y NVFP4, listos para usar desde el día cero en Ollama y SGLang.
Datos rápidos
| Desarrollador | Liquid AI |
|---|---|
| Modelos incluidos | 6 modelos de ~1.7B a 2B sobre LFM3-1.7B-Base |
| Modalidades | Texto (256K), Visión+Vídeo, Audio en 18 idiomas, Omni y Decisión |
| Formatos | Safetensors, GGUF, ONNX, MLX, FP8 y NVFP4 |
| Ejecución y ajuste | Soporte día cero en SGLang y Ollama; ajuste fino en 1 GPU |
| Categoría | IA y modelos |
| Creador | leonie |
| Sitio oficial | huggingface.co ↗ |
| Popularidad | 🔥 24,3K Popularidad |
| Publicado | |
| Última actualización |
Seis especialistas de clase 2B sobre una arquitectura trihíbrida común
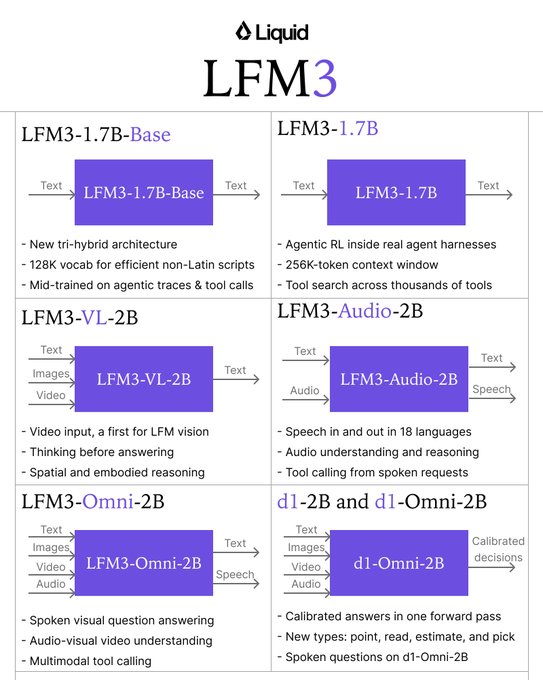
En lugar de publicar un único modelo pesado, Liquid AI ha estructurado el estreno de LFM3 como una familia de seis modelos compactos de unos 2.000 millones de parámetros que comparten el tronco LFM3-1.7B-Base. Su nueva arquitectura trihíbrida y sus codificadores multimodales están optimizados para 14 clases de procesadores repartidas entre GPU, CPU y NPU.
El modelo de texto LFM3-1.7B alcanza una ventana de contexto de 256K tokens pensada para ejecutar miles de pequeños agentes en paralelo, mientras que el modelo de visión y lenguaje LFM3-VL-2B (1,9B parámetros) incorpora entrada de vídeo para comprensión espacial y compite con modelos seis veces mayores como Gemma 4 12B.
Voz en 18 idiomas y modelos de decisión d1 en una sola pasada
En el terreno del audio, LFM3-Audio-2B ofrece entrada y salida de voz con llamadas a herramientas y razonamiento en 18 idiomas, y LFM3-Omni-2B combina visión, audio y lenguaje en un único modelo.
Además de los cuatro modelos generativos, la familia estrena d1-2B y d1-Omni-2B (con entrada de audio): dos modelos de decisión que devuelven salidas tipadas y probabilidades calibradas en una sola pasada, ideales para clasificación, enrutamiento y control de flujos sin latencia de generación.
Ajuste fino en una GPU y cuantizaciones listas para GGUF y MLX
En la colección oficial de LiquidAI en Hugging Face, cada modelo viene acompañado de versiones preconvertidas a GGUF, ONNX, MLX para equipos Mac con Apple Silicon, FP8 y NVFP4.
Tanto SGLang como Ollama ofrecen soporte desde el primer día, y cualquier equipo puede ajustar cualquiera de las seis variantes en una sola GPU para convertirla en un especialista de su propio dominio.
Guía paso a paso
Abrir la colección LFM3 en Hugging Face
Pulsa el botón superior para explorar los seis modelos base y postentrenados junto con sus versiones cuantizadas.
Elegir la variante según modalidad y hardware
Selecciona 1.7B para texto, VL-2B para vídeo, Audio-2B u Omni-2B para voz, o d1-2B para decisiones tipadas en formato GGUF, MLX o FP8.
Ejecutar con Ollama o SGLang
Lanza el modelo localmente con Ollama, despliega en servidor con SGLang o ajústalo en una única GPU.
Preguntas frecuentes
¿Qué seis modelos componen el primer lanzamiento de LFM3?
Incluye LFM3-1.7B (texto), LFM3-VL-2B (visión y vídeo), LFM3-Audio-2B (voz bidireccional), LFM3-Omni-2B (visión, audio y texto) y los modelos de decisión d1-2B y d1-Omni-2B.
¿Cuál es el tamaño de contexto de LFM3-1.7B?
Admite una ventana de contexto de hasta 256K tokens.
¿En qué consisten los modelos d1-2B y d1-Omni-2B?
Son modelos de decisión que entregan salidas tipadas y probabilidades calibradas en una sola pasada, añadiendo entrada de audio en d1-Omni-2B.
¿En qué formatos se pueden descargar los pesos?
Se publican en Safetensors, GGUF, ONNX, MLX, FP8 y NVFP4, con soporte directo en Ollama y SGLang.




