一分钟看懂
- 首批开源 6 款 2B 级模型,全部基于同一个 LFM3-1.7B-Base 底座,覆盖纯文本、视觉视频、双向语音、全模态与结构化决策。
- 采用新三混合(tri-hybrid)架构与多模态编码器,针对 GPU、CPU、NPU 共 14 类处理器专门优化,仅需 1 张 GPU 即可微调出垂直领域专精模型。
- 19 亿参数的 LFM3-VL-2B 支持视频输入与空间理解,官方测试可与体积大 6 倍的 Gemma 4 12B 及 Gemini 3.5 Flash Lite 同台竞争。
- Hugging Face 官方合集同步提供 GGUF、ONNX、苹果 MLX、FP8 与 NVFP4 格式,SGLang 与 Ollama 首日原生支持。
基本信息
| 发布机构 | Liquid AI |
|---|---|
| 首批阵容 | 6 款约 1.7B–2B 参数模型(共享 LFM3-1.7B-Base) |
| 覆盖模态 | 256K 文本、图像+视频、18 语种语音、Omni 全模态、d1 决策 |
| 预转格式 | Safetensors、GGUF、ONNX、MLX、FP8、NVFP4 |
| 推理与微调 | SGLang 与 Ollama 首日支持;单张 GPU 即可微调 |
| 分类 | AI 前沿 |
| 作者 / 发布方 | leonie |
| 官方入口 | huggingface.co ↗ |
| 热度 | 🔥 热度 2万 |
| 发布时间 | |
| 数据更新 |
共享 1.7B 底座的六姐妹:从并发小智能体到视频空间理解
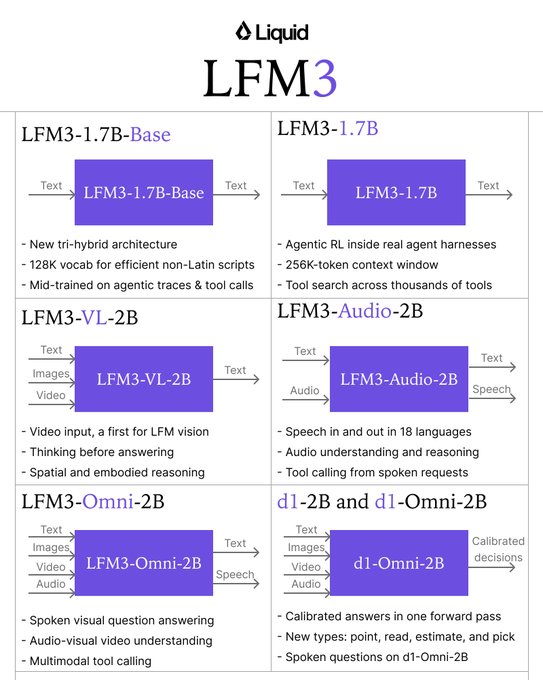
LFM3 没有走盲目堆大参数的路线,而是以“三混合架构(tri-hybrid architecture)”配合全新多模态编码器,把首批 6 个模型全部控制在 2B 量级。官方针对横跨 GPU、CPU 和 NPU 的 14 类处理器做了深度适配,让这套模型既能在端侧芯片上跑起来,也能在服务器端同时并行拉起成千上万个微型智能体。
具体来看,文本主模型 LFM3-1.7B 具备 256K 上下文窗口;视觉语言模型 LFM3-VL-2B(约 19.1 亿参数)新增视频输入与空间理解能力,官方标称表现可比肩体积大 6 倍的 Gemma 4 12B、Gemini 3.5 Flash Lite 以及 GPT-5.6 Luna。
- LFM3-1.7B(文本)
拥有 256K 超长上下文,专为高并发并行运行数千个轻量智能体设计。
- LFM3-VL-2B(视觉与视频)
支持图像与视频流输入及空间理解,以 1.9B 体量对标 12B 级多模态模型。
- LFM3-Audio-2B 与 Omni-2B
Audio-2B 支持 18 种语言的语音输入输出、工具调用与推理;Omni-2B 则将视觉、语音与文本合三为一。
单次前向传播给出类型化结果与校准概率的 d1 决策模型
在 4 个生成式模型之外,LFM3 系列还首次推出了两款专门服务工程管线的“决策模型”:d1-2B 与 d1-Omni-2B(额外支持音频输入)。传统大模型做分类或路由时往往要逐字生成文本再用正则解析,而 d1 系列在单次前向计算(single pass)中就能直接返回强类型输出(typed outputs)以及经过校准的概率值(calibrated probabilities)。
对于意图路由、风控审核、语音工单分流或智能体动作选择等业务场景,单次计算拿到校准置信度不仅能大幅压低延迟,还能让下游代码直接按概率阈值做确定性分支处理。
单卡可微调,GGUF、MLX 与 NVFP4 全格式首日即用
为了降低落地门槛,Liquid AI 在 Hugging Face 的 LFM3 官方合集里一次性放出了 GGUF、ONNX、专为苹果芯片准备的 MLX、FP8 以及 NVFP4 等多种量化与导出版本。
推理框架方面,SGLang 和 Ollama 均在发布当天完成了首日支持;如果企业需要针对自有业务数据做定制,6 款模型都可以在单张 GPU 上完成微调,训成各自领域的专精小模型。
上手步骤
打开 Hugging Face 上的 LFM3 合集
点击上方按钮进入 LiquidAI/lfm3 官方合集页面,查看 6 款模型及对应的量化仓库。
按业务模态与硬件挑选格式
文本与多智能体选 LFM3-1.7B,视频理解选 VL-2B,语音交互选 Audio-2B 或 Omni-2B,并按设备下载 GGUF、MLX 或 FP8 权重。
用 Ollama 或 SGLang 一键启动
使用首日支持 LFM3 的 Ollama 在本地运行,或通过 SGLang 部署高并发服务,也可在单张 GPU 上微调专属模型。
常见问题
Liquid AI LFM3 首批开源了哪 6 个模型?
包括 LFM3-1.7B(256K 文本)、LFM3-VL-2B(支持视频的视觉语言模型)、LFM3-Audio-2B(18 语种双向语音)、LFM3-Omni-2B(视觉+语音+文本全模态),以及 d1-2B 和 d1-Omni-2B 两款决策模型。
d1-2B 和 d1-Omni-2B 决策模型有什么特别之处?
它们专为结构化判定设计,在单次前向推理中就能直接输出强类型结果与校准后的概率分布,其中 d1-Omni-2B 还支持直接输入音频。
LFM3-VL-2B 的参数量和性能如何?
LFM3-VL-2B 约有 19.1 亿参数,支持图像和视频空间理解,官方表示其表现可与参数量大 6 倍的 Gemma 4 12B 及 Gemini 3.5 Flash Lite 竞争。
个人电脑或 Mac 能直接跑 LFM3 吗?
可以。官方已同步提供 GGUF、ONNX 和针对苹果芯片的 MLX 格式,并且 Ollama 与 SGLang 均已提供首日支持。




