핵심 요약
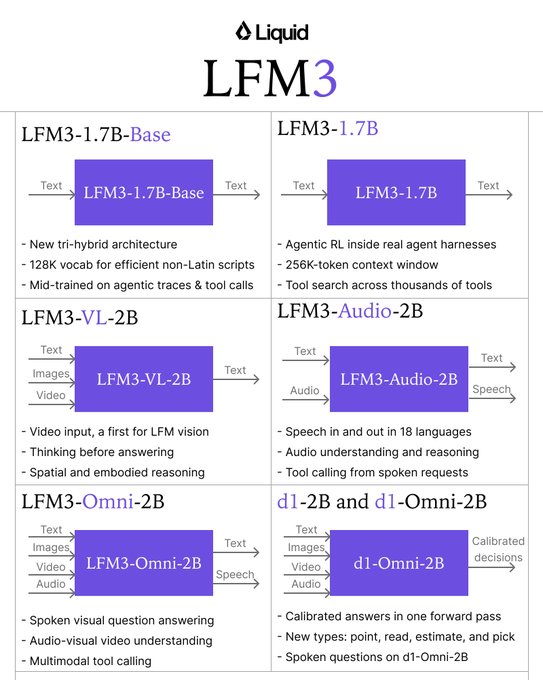
- 공통 베이스 모델 LFM3-1.7B-Base 위에서 구축된 2B급 오픈 웨이트 모델 6종(1.7B, VL-2B, Audio-2B, Omni-2B, d1-2B, d1-Omni-2B)을 출시했습니다.
- 새로운 트라이하이브리드 아키텍처로 GPU, CPU, NPU에 걸친 14개 프로세서 클래스에 최적화되었으며 GPU 1장으로 도메인 특화 파인튜닝이 가능합니다.
- 19억 파라미터의 LFM3-VL-2B는 비디오 입력을 통한 공간 이해를 지원하며 6배 큰 Gemma 4 12B 및 Gemini 3.5 Flash Lite와 대등하게 경쟁합니다.
- 허깅페이스에서 GGUF, ONNX, MLX, FP8, NVFP4 포맷을 함께 배포하며 SGLang과 Ollama를 출시 첫날부터 지원합니다.
한눈에 보기
| 개발사 | Liquid AI |
|---|---|
| 출시 구성 | 2B급 모델 6종 (공통 LFM3-1.7B-Base 기반) |
| 지원 모달리티 | 텍스트(256K), 비전·비디오, 18개국어 음성, 옴니, 의사결정 |
| 제공 포맷 | Safetensors, GGUF, ONNX, MLX, FP8, NVFP4 |
| 실행 및 튜닝 | SGLang·Ollama 데이제로 지원 / 단일 GPU 파인튜닝 |
| 카테고리 | AI·모델 |
| 제작자 | leonie |
| 공식 사이트 | huggingface.co ↗ |
| 화제도 | 🔥 화제도 2만 |
| 공개일 | |
| 최종 업데이트 |
공통 1.7B 베이스에서 뻗어 나온 6종의 2B급 특화 모델
Liquid AI의 LFM3 첫 릴리스는 새로운 트라이하이브리드 아키텍처와 멀티모달 인코더를 결합해 2B급 크기에서 텍스트, 비전, 오디오, 옴니 모달리티를 모두 처리하도록 설계되었습니다. GPU, CPU, NPU를 포함한 14개 프로세서 클래스에 맞춰 최적화되어 엣지 기기부터 대규모 병렬 서버까지 폭넓게 대응합니다.
텍스트 모델인 LFM3-1.7B는 256K 컨텍스트 창을 지원해 수천 개의 초소형 에이전트를 병렬 실행하기에 적합하며, 19억 파라미터 규모의 LFM3-VL-2B는 비디오 입력을 지원해 공간 이해 작업에서 6배 더 큰 Gemma 4 12B 및 Gemini 3.5 Flash Lite와 경쟁하는 성능을 보여줍니다.
18개 국어 양방향 음성과 단일 패스 확률을 출력하는 d1 의사결정 모델
음성 모델인 LFM3-Audio-2B는 음성 입력과 음성 출력을 모두 지원하며 18개 언어로 음성 대화, 추론, 도구 호출을 수행합니다. LFM3-Omni-2B는 비전, 오디오, 언어를 하나로 묶은 Liquid AI 최초의 옴니 모델입니다.
여기에 생성형 모델과 구별되는 의사결정 모델 d1-2B와 오디오 입력을 더한 d1-Omni-2B가 함께 공개되었습니다. 이 모델들은 단 한 번의 패스(single pass)로 타입이 지정된 출력(typed outputs)과 보정된 확률값(calibrated probabilities)을 반환해 라우팅이나 분류 파이프라인에 즉시 투입할 수 있습니다.
단일 GPU 파인튜닝과 GGUF·MLX·Ollama 즉시 지원
허깅페이스의 LiquidAI LFM3 컬렉션에는 기본 가중치 외에도 로컬 실행을 위한 GGUF, ONNX, 애플 실리콘용 MLX, FP8, NVFP4 변환 모델이 함께 등록되어 있습니다.
출시 당일부터 SGLang과 Ollama를 공식 지원하며, 6종 모두 단일 GPU에서 파인튜닝해 특정 산업이나 업무에 맞춘 소형 전문가 모델로 만들 수 있습니다.
단계별 가이드
허깅페이스 LFM3 컬렉션 열기
상단 버튼을 눌러 LiquidAI 공식 컬렉션에서 6종의 모델과 양자화 저장소를 확인합니다.
모달리티와 하드웨어에 맞는 포맷 선택
텍스트 에이전트는 1.7B, 비디오는 VL-2B, 음성은 Audio-2B나 Omni-2B를 고르고 GGUF, MLX, FP8 중 환경에 맞는 포맷을 받습니다.
Ollama·SGLang 실행 및 단일 GPU 튜닝
Ollama나 SGLang으로 즉시 로컬·서버 추론을 실행하거나 GPU 1장으로 도메인 특화 미세조정을 진행합니다.
자주 묻는 질문
LFM3 첫 릴리스에는 어떤 모델들이 포함되어 있나요?
LFM3-1.7B(텍스트), LFM3-VL-2B(비전·비디오), LFM3-Audio-2B(양방향 음성), LFM3-Omni-2B(비전·음성·언어 통합), 그리고 의사결정 모델인 d1-2B와 d1-Omni-2B 총 6종입니다.
LFM3-1.7B의 컨텍스트 길이는 얼마인가요?
최대 256K 토큰 컨텍스트 윈도우를 지원합니다.
d1-2B와 d1-Omni-2B는 일반 언어 모델과 어떻게 다른가요?
자유 형식 텍스트 대신 단일 패스로 타입이 지정된 출력과 보정된 확률을 반환하는 의사결정 특화 모델이며, d1-Omni-2B는 오디오 입력도 처리합니다.
어떤 실행 포맷과 추론 엔진을 지원하나요?
GGUF, ONNX, MLX, FP8, NVFP4 포맷을 공식 제공하며 SGLang과 Ollama에서 바로 실행할 수 있습니다.




