Das Wichtigste in Kürze
- Getrennt trainierte JEPAs können bis auf eine Drehung dieselbe Weltrepräsentation lernen, auch ohne Bild-Text-Paare.
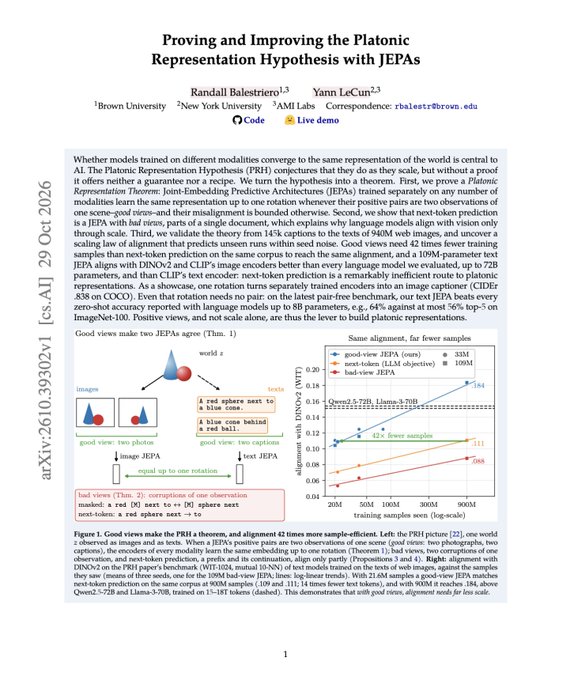
- Next-Token-Prediction gilt in der Arbeit als schlechte Sicht, gute Sichten brauchen 42-fach weniger Trainingsbeispiele.
- Ein Text-JEPA mit 109 Millionen Parametern richtet sich stärker aus als bewertete Sprachmodelle bis 72 Milliarden.
Kurzüberblick
| Text-JEPA | 109 Millionen Parameter |
|---|---|
| Sample-Vorteil | 42-fach weniger Beispiele als Next-Token-Prediction |
| Sprachmodell-Vergleich | bis 72 Milliarden Parameter |
| COCO-CIDEr | 0,838 nach einer Rotation |
| Kategorie | KI & Modelle |
| Urheber | alphaXiv |
| Offizielle Seite | alphaxiv.org ↗ |
| Trend-Index | 🔥 177,9 Tsd. Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
Wann zwei getrennte Modelle dieselbe Welt sehen
Zwei völlig getrennt trainierte JEPAs können im Wesentlichen dieselbe zugrunde liegende Weltrepräsentation lernen.
Die Platonische Repräsentationshypothese sagt, dass Modelle aus verschiedenen Modalitäten, etwa Bild und Text, auf eine ähnliche Darstellung der Welt zulaufen. Bisher war das eine Vermutung über Skalierung, ohne Garantie und ohne Bauanleitung. LeCun und Balestriero machen daraus ein Theorem für Joint-Embedding Predictive Architectures, kurz JEPA.
Der Kern ist die gute Sicht. Positive Beispiele sind zwei Beobachtungen derselben Szene, und alle übrigen Abweichungen bleiben beschränkt. Unter diesen Bedingungen lernen die Encoder bis auf eine Drehung dieselbe Repräsentation. Ein Modell sieht verschiedene Bilder der Szene, das andere verschiedene Beschreibungen. Bild-Text-Paare braucht das Training nicht.
Warum das nächste Token die schlechte Sicht ist
Wie ein Modell trainiert wird, wiegt schwerer als es einfach nur größer zu machen.
Die Arbeit fasst Next-Token-Prediction als JEPA mit schlechter Sicht: Positive Beispiele sind Ausschnitte desselben Dokuments, nicht zwei Blicke auf dieselbe Szene. Daraus folgt die Erklärung, warum Sprachmodelle die Angleichung an das Sehen vor allem über Größe holen. Größer skalieren ist damit nicht mehr die einzige Lesart der Hypothese.
Geprüft wird das von 145.000 Bildunterschriften bis zu den Texten von 940 Millionen Webbildern. Dabei tritt ein Skalierungsgesetz der Ausrichtung zutage, das ungesehene Läufe innerhalb des Seed-Rauschens vorhersagt. Die gute Sicht ist der Hebel, der die Ausrichtung auch ohne reines Größenwachstum streckt.
- Schlechte Sicht
Dieselbe Quelle wird in Fragmente zerlegt, wie beim nächsten Token in einem Dokument.
- Gute Sicht
Zwei Beobachtungen gehören zur selben Szene, restliche Abweichungen bleiben beschränkt.
- Folge für Sprachmodelle
Die visuelle Angleichung bleibt dann vor allem eine Frage der Skalierung.
Kleine Encoder, große Ausrichtung
Dieselbe Bild-Text-Ausrichtung gelingt mit 42-fach weniger Trainingsbeispielen als bei Next-Token-Prediction.
Auf demselben Korpus erreicht die gute Sicht die vergleichbare Ausrichtung mit 42-fach weniger Lernbeispielen. Das Text-JEPA mit 109 Millionen Parametern liegt näher an den Bild-Encodern von DINOv2 und CLIP als die geprüften Sprachmodelle bis 72 Milliarden Parameter und als der Text-Encoder von CLIP.
Eine einzige Drehung zwischen getrennt trainierten Encodern macht daraus einen Bildunterschriftengenerator, ohne dass diese Drehung Paare braucht. Auf COCO liegt der CIDEr-Wert bei 0,838. Auf dem aktuellen paarfreien Benchmark erreicht das Text-JEPA 64 Prozent Top-5 auf ImageNet-100 und liegt damit über jedem berichteten Zero-Shot-Wert von Sprachmodellen bis 8 Milliarden Parameter, deren Maximum bei 56 Prozent liegt.
| Vergleich | Text-JEPA | Referenz aus der Arbeit |
|---|---|---|
| Parameter | 109 Millionen | Sprachmodelle bis 72 Milliarden |
| ImageNet-100, Top-5 | 64 Prozent | höchstens 56 Prozent bis 8 Milliarden |
| COCO, CIDEr | 0,838 | eine Rotation, ohne Paare |
Häufige Fragen
Wo liegt die Arbeit, und gibt es eine App oder API?
Die offizielle Seite steht auf alphaxiv.org. Beschrieben ist die Forschungsarbeit, keine App, kein Preismodell und keine API.
Muss das Training Bild und Text als Paar sehen?
Nein. Die beiden JEPAs lernen getrennt, eines an verschiedenen Bildern derselben Szene, das andere an verschiedenen Beschreibungen. Die spätere Drehung zwischen den Encodern kommt ebenfalls ohne Paare aus.




