Puntos clave
- LeCun y Balestriero convierten la hipótesis platónica en un teorema: dos JEPA separados pueden aprender la misma representación salvo una rotación.
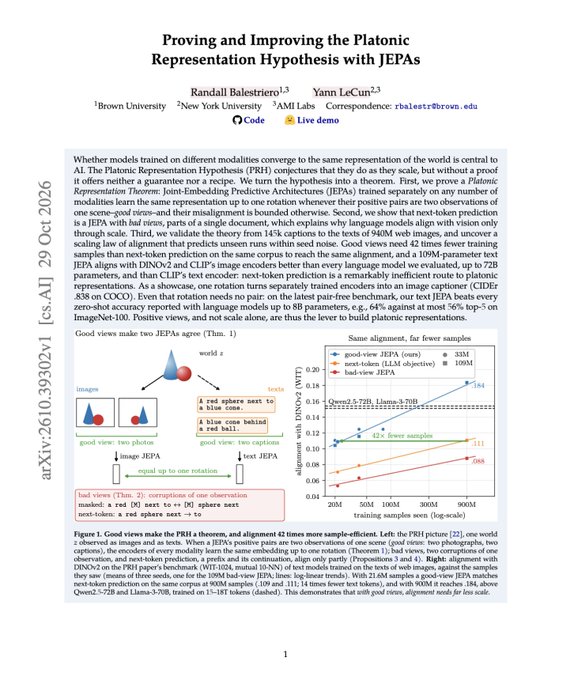
- Una vista buena alcanza la misma alineación imagen-texto con 42 veces menos muestras que la predicción del siguiente token.
- Un JEPA de texto de 109 millones de parámetros supera en alineación cruzada a modelos de lenguaje de hasta 72 mil millones.
Datos rápidos
| Autores | Yann LeCun y Randall Balestriero |
|---|---|
| Dónde leerlo | Página oficial en alphaxiv.org |
| Texto JEPA | 109 millones de parámetros |
| Ahorro de muestras | 42 veces menos que el siguiente token |
| Categoría | IA y modelos |
| Creador | alphaXiv |
| Sitio oficial | alphaxiv.org ↗ |
| Popularidad | 🔥 177,9K Popularidad |
| Publicado | |
| Última actualización |
La conjetura que pasa a teorema
La forma de entrenar importa más que limitarse a escalar el modelo.
La hipótesis de la representación platónica (プラトン的表象仮説) plantea que modelos entrenados en modalidades distintas, como imagen y texto, acaban aprendiendo representaciones parecidas del mundo. Hasta ahora era una conjetura ligada al tamaño: sin prueba, no daba garantía ni receta.
El trabajo la convierte en teorema para los JEPA. Si los ejemplos positivos son dos observaciones de la misma escena y el resto de los desajustes está acotado, dos JEPA entrenados por completo aparte aprenden esencialmente la misma representación, salvo una rotación. Uno ve imágenes distintas de esa escena y el otro lee descripciones distintas, sin pares imagen-texto.
Por qué el siguiente token es una mala vista
La predicción del siguiente token queda descrita como un JEPA de mala vista.
En ese encuadre, los positivos son fragmentos del mismo documento. Por eso un modelo de lenguaje solo acerca su representación a la visual a fuerza de escala. Es una respuesta directa a la idea de que agrandar el modelo basta para alinear modalidades.
La comprobación va de 145.000 descripciones a los textos de 940 millones de imágenes web. También aparece una ley de escala de la alineación que predice ejecuciones no vistas dentro del ruido de la semilla. La vista buena se presenta como palanca para subir la alineación sin depender solo del tamaño.
Menos muestras y un uso concreto
Una sola rotación convierte encoders entrenados por separado en un generador de pies de imagen.
En el mismo corpus, la vista buena llega a una alineación equivalente con 42 veces menos muestras de entrenamiento que la predicción del siguiente token. El JEPA de texto de 109 millones de parámetros se alinea mejor con los encoders de imagen DINOv2 y CLIP que los modelos de lenguaje evaluados, de hasta 72 mil millones de parámetros, y que el encoder de texto de CLIP.
Buscar esa rotación entre encoders separados alcanza un CIDEr de 0,838 en COCO. En el benchmark sin pares más reciente, el mismo texto JEPA llega al 64% de top-5 en ImageNet-100, por encima del máximo del 56% informado con modelos de lenguaje de hasta 8 mil millones. El acceso público es la página del trabajo en alphaxiv.org; allí no se detallan app, API, pesos abiertos ni precios.
| Resultado | Cifra |
|---|---|
| Muestras frente al siguiente token | 42 veces menos |
| Texto JEPA frente a LLMs | 109 millones supera hasta 72 mil millones |
| Pies de imagen en COCO | CIDEr 0,838 |
| ImageNet-100 top-5 sin pares | 64% frente a un máximo del 56% hasta 8 mil millones |
Preguntas frecuentes
¿Hace falta entrenar con pares de imagen y texto?
No para el resultado central. El teorema cubre dos JEPA entrenados por separado: uno con imágenes de la misma escena y otro con descripciones de esa escena.
¿Qué implica que las representaciones coincidan salvo una rotación?
Que una transformación lineal basta para ponerlas en correspondencia. En el trabajo, calcular esa rotación entre encoders separados produce un generador de pies de imagen.