要点まとめ
- 別々に訓練した二つのJEPAは、条件を満たすと回転を除いて同じ世界表象を学ぶ。
- 次トークン予測は「悪い視点」のJEPAで、視覚との整合が規模に頼りやすい理由になる。
- 良い視点は42倍少ない学習サンプルで同等の整合に達し、1億900万パラメータのテキストJEPAが最大720億パラメータ級を上回った。
基本情報
| 掲載 | 2026年11月1日、alphaXiv(alphaxiv.org) |
|---|---|
| 中心のモデル | 1億900万パラメータのテキストJEPA |
| 比較した言語モデル | 評価した最大720億パラメータまで |
| サンプル効率 | 次トークン予測の42分の1で同等の画像・テキスト整合 |
| カテゴリ | AI・新モデル |
| 作者・提供元 | alphaXiv |
| 公式サイト | alphaxiv.org ↗ |
| 注目度 | 🔥 注目度 17万 |
| 公開日 | |
| 最終更新 |
別々に学んでも同じ世界像に届く条件
訓練の仕方が、単にモデルを大きくすることより重要だ。
プラトン的表象仮説は、画像やテキストなど異なるモダリティで訓練したAIが、やがて似た世界の表象を学ぶ、という見方です。alphaXivに掲載されたLeCunとBalestrieroの論文は、これを経験則のままにせず、JEPAについての定理へ変えています。
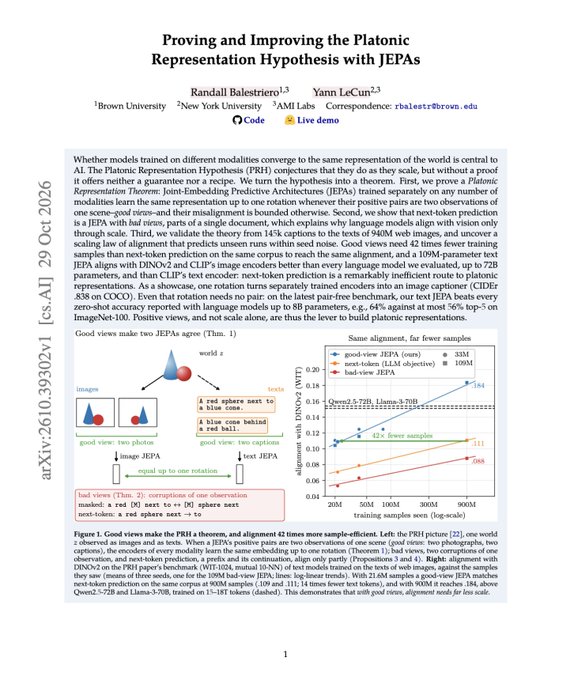
画像と文章のペアは不要です。一方のJEPAは同一場面の異なる画像から、もう一方は同じ場面の異なる記述から、まったく別々に学びます。正例が同一場面の二つの観測で、それ以外のズレが有界なら、両者は回転を除いて本質的に同じ表象を学ぶ、というのが中核の保証です。
- 良い視点
正例が同一場面の二つの観測になり、それ以外のズレが有界であること。
- 残る自由度
一致は完全な同一ではなく、一回転を除いた表象として保証される。
- 設計指針
どこまで大きくするかより、何を正例にするかが先に来る。
次トークン予測が悪い視点になる理由
論文は次トークン予測を、同一文書の断片を正例にする悪い視点のJEPAとして位置づけます。この見方だと、言語モデルが視覚エンコーダと揃うには規模に頼りやすくなります。大きくすれば自然に揃う、という理解への反論です。
検証は14万5000件のキャプションから、9億4000万枚のWeb画像に付くテキストまで広がります。整合のスケーリング則は、未見の実行結果をシードノイズの範囲で予測できたとされます。良い視点は、規模とは別のレバーとして示されています。
| 視点 | 正例の取り方 | 整合の伸び方 |
|---|---|---|
| 良い視点のJEPA | 同一場面の異なる観測 | 規模以外のレバーになり、サンプルも少なくて済む |
| 次トークン予測 | 同一文書の断片 | 悪い視点のため、視覚との整合が規模に寄りやすい |
少ないサンプルで巨大モデルを超えた整合
1億900万パラメータのテキストJEPAが、最大720億パラメータの言語モデルをクロスモーダル整合で上回った。
同じコーパスで同等の画像・テキスト整合に達するのに、良い視点は次トークン予測の42分の1の学習サンプルで済みます。1億900万パラメータのテキストJEPAは、評価した最大720億パラメータの言語モデル群やCLIPのテキストエンコーダより、DINOv2とCLIPの画像エンコーダとよく揃いました。
使い道の実演では、別々に訓練したエンコーダのあいだの一回転を求めるだけで画像キャプション生成器になります。COCOのCIDErは0.838です。ペアなしベンチマークでもImageNet-100のtop-5が64%で、8Bパラメータまでの言語モデルで報告された最大56%を上回りました。
論文として読む場所と、まだ開いている点
公開されているのはモデルのアプリやAPIではなく、論文の公式ページです。本文と概要はalphaxiv.orgで読めます。重みの配布や料金は、今回の発表情報には含まれていません。
定理が保証するのは、良い視点と有界なズレという条件のもとで、回転を除いた一致です。条件を外したときの挙動や、ページにあるLimitsの細部は、本文を当たって確認する必要があります。
よくある質問
画像とキャプションのペアで訓練しているのですか?
していません。画像側と文章側のJEPAは別々に訓練され、ペアなしでも回転を除いて同じ表象へ収束しうることが定理の主張です。
すぐに呼び出せるモデルやAPIはありますか?
発表時点で確認できるのはalphaxiv.orgの論文ページです。アプリ、API、公開ウェイト、料金の記載はありません。