핵심 요약
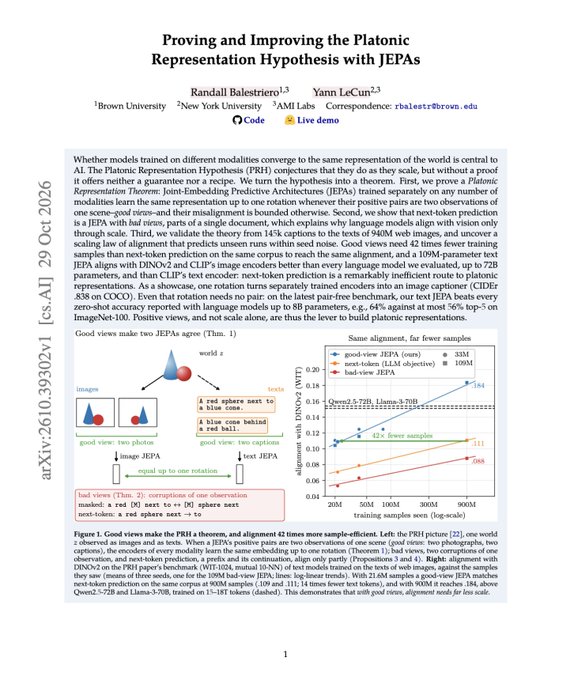
- 따로 학습한 두 JEPA는 좋은 시점 조건에서 회전을 빼면 같은 표상을 배워요.
- 다음 토큰 예측은 나쁜 시점의 JEPA라서, 시각 정렬이 규모에 기댑니다.
- 1억 900만 파라미터 텍스트 JEPA가 평가한 최대 720억 파라미터 언어모델보다 이미지 인코더와 잘 맞았어요.
한눈에 보기
| 발표 | 2026년 11월 1일, alphaXiv |
|---|---|
| 텍스트 JEPA | 1억 900만 파라미터 |
| 비교 상한 | 최대 720억 파라미터 언어모델 |
| 샘플 효율 | 같은 코퍼스에서 42배 적은 학습 샘플 |
| 카테고리 | AI·모델 |
| 제작자 | alphaXiv |
| 공식 사이트 | alphaxiv.org ↗ |
| 화제도 | 🔥 화제도 17만 |
| 공개일 | |
| 최종 업데이트 |
따로 배운 모델이 같은 세계에 닿는 조건
어떻게 학습하느냐가 단순히 키우는 것보다 더 중요합니다.
플라톤적 표상 가설(プラトン的表象仮説)은 이미지와 텍스트처럼 다른 양식으로 학습한 모델이 결국 비슷한 세계 표상으로 모인다는 추측이에요. 얀 르쿤과 랜들 발레스트리에로의 논문은 이 추측을 JEPA 정리로 바꿔, 보장과 설계 조건을 붙입니다.
핵심은 쌍으로 가르치지 않아도 된다는 점이에요. 한쪽은 같은 장면의 서로 다른 이미지를, 다른 쪽은 그 장면의 서로 다른 설명을 보고 따로 학습합니다. 긍정 예가 같은 장면의 두 관측이고 그 밖의 어긋남이 유계이면, 두 JEPA는 회전을 제외하고 본질적으로 같은 표상을 배워요.
다음 토큰 예측은 왜 나쁜 시점인가
다음 토큰 예측은 나쁜 시점의 JEPA로 위치합니다.
논문은 다음 토큰 예측을, 같은 문서의 조각을 긍정 예로 삼는 나쁜 시점의 JEPA로 봐요. 그래서 언어모델은 시각과의 정렬을 규모에 기대게 되고, 크게 만들면 맞춰진다는 통념에 수학적 반례가 생깁니다.
검증은 캡션 14만 5천 건에서 웹 이미지 9억 4천만 장의 텍스트까지 이어져요. 정렬의 스케일링 법칙은 아직 보지 않은 실행을 시드 노이즈 안에서 예측합니다. 좋은 시점은 규모만으로 정렬을 밀지 않는 레버로 제시돼요.
- 좋은 시점
같은 장면의 두 관측을 긍정 예로 두고, 나머지 어긋남을 유계로 유지해요.
- 나쁜 시점
같은 문서의 앞뒤 조각을 긍정 예로 쓰는 다음 토큰 예측이 여기에 해당해요.
- 정리의 범위
표상은 완전 동일이 아니라 회전을 허용한 동일로 보장됩니다.
적은 샘플로 거대 모델을 넘은 정렬
같은 코퍼스에서 같은 수준의 정렬에 닿을 때, 좋은 시점은 다음 토큰 예측보다 42배 적은 학습 샘플로 충분했어요. 1억 900만 파라미터 텍스트 JEPA는 평가 대상 중 최대 720억 파라미터 언어모델과 CLIP 텍스트 인코더보다 DINOv2·CLIP 이미지 인코더와 더 잘 맞습니다.
따로 학습한 인코더 사이의 회전 하나만 구하면 이미지 캡션 생성기가 되고, COCO에서 CIDEr .838을 기록했어요. 쌍이 없는 벤치마크의 ImageNet-100 top-5는 64%로, 8B까지 언어모델에서 보고된 최대 56%를 넘습니다. 가중치, API, 요금은 공개 페이지에 적혀 있지 않고, 정리는 좋은 시점과 유계 조건 안에서 성립해요.
논문 페이지는 alphaxiv.org에 있어요. 제목은 Proving and Improving the Platonic Representation Hypothesis with JEPAs입니다.
| 비교 | 결과 |
|---|---|
| 학습 샘플 | 다음 토큰 예측 대비 42배 적음 |
| 교차 모달 정렬 | 1.09억 텍스트 JEPA가 최대 720억 LM보다 우수 |
| COCO 캡션 | 회전 하나로 CIDEr .838 |
| ImageNet-100 top-5 | 64%, 8B까지 LM 보고치 최대 56% |
자주 묻는 질문
이미지-텍스트 쌍으로 학습해야 하나요?
아니에요. 논문의 설정은 쌍 없이, 같은 장면의 다른 이미지와 다른 설명을 각각 따로 학습합니다.
모델을 바로 써 볼 수 있나요?
공개된 것은 alphaxiv.org의 논문 페이지예요. 앱, API, 오픈 웨이트나 가격은 이번 자료에 없습니다.