一分钟看懂
- 分开训练、且从不看图文配对的两个JEPA,在好视角条件下会学到只差一次旋转的同一表征。
- 下一词预测被写成坏视角的JEPA,因此语言模型与视觉的对齐更依赖规模。
- 1.09亿参数文本JEPA在跨模态对齐上超过评估中最大720亿参数的语言模型,同等对齐只需约四十二分之一的训练样本。
基本信息
| 文本JEPA规模 | 1.09亿参数 |
|---|---|
| 对齐对照上限 | 评估中最大720亿参数语言模型 |
| 样本效率 | 同等图文对齐约为下一词预测样本数的1/42 |
| 入口 | 论文页在 alphaxiv.org |
| 分类 | AI 前沿 |
| 作者 / 发布方 | alphaXiv |
| 官方入口 | alphaxiv.org ↗ |
| 热度 | 🔥 热度 17万 |
| 发布时间 | |
| 数据更新 |
假说怎样变成一条JEPA定理
在特定条件下,两个完全分开训练的JEPA可以学到本质上相同的世界表征。
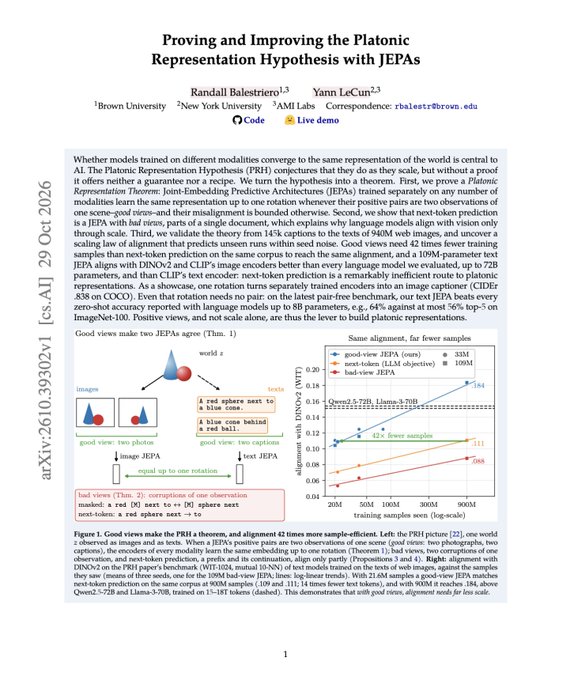
柏拉图表征假说认为,图像、文本等不同模态上训练的模型,会逐渐收敛到相似的世界表征。这篇论文给出的是定理而不是经验观察:一个JEPA只看同一场景的不同图像,另一个只看该场景的不同文字描述,训练阶段不使用图文配对,两者仍可对齐。
保证来自好视角。正例必须是同一场景的两次观测,其余偏差保持有界时,两个JEPA学到的表征在旋转意义下相同。假说因此带上可核对的条件,也给出该如何设计训练视角。
- 图像侧
正例来自同一场景的不同图像。
- 文本侧
正例来自该场景的不同描述,不与图像组成训练对。
- 对齐方式
两边表征在去掉一次旋转后视为相同。
下一词预测为何被写成坏视角
模型怎么训练,比单纯把规模做大更关键。
论文把下一词预测看成一种JEPA:正例只是同一篇文档里的片段,属于坏视角。在这个解释里,语言模型要和视觉对齐,主要只能靠把规模做大。
验证覆盖从14.5万条描述,到9.4亿张网页图像所对应的文本。文中还给出对齐的缩放规律,能把尚未跑过的实验预测到随机种子噪声以内。好视角被呈现为拉动对齐的杠杆,规模不再是唯一旋钮。
小文本模型在对齐上超过大语言模型
同样的图文对齐,好视角比下一词预测少用42倍训练样本。
在同一语料上达到同等对齐时,好视角所需训练样本是下一词预测的四十二分之一。1.09亿参数的文本JEPA,与DINOv2及CLIP图像编码器的对齐,好过评估中最大720亿参数的语言模型,也好过CLIP的文本编码器。
分开训练的编码器之间只求一次旋转,就能变成图像描述器,在COCO上CIDEr为0.838,而且这次旋转本身不需要图文对。在最新的无配对基准上,该文本JEPA超过此前用不超过80亿参数语言模型报告的全部零样本准确率:ImageNet-100的top-5为64%,对照最高为56%。
| 结果 | 数字 |
|---|---|
| 同等对齐的样本量 | 约为下一词预测的1/42 |
| 文本JEPA参数量 | 1.09亿 |
| 对照语言模型规模 | 评估至720亿参数 |
| COCO图像描述 | CIDEr 0.838 |
| ImageNet-100 top-5 | 64%,对照不超过80亿参数语言模型最高56% |
能拿来做什么,保证停在哪里
一次旋转就把分开训练的编码器变成图像描述器。
论文页在 alphaxiv.org,题为用JEPA证明并改进柏拉图表征假说。公开信息停留在这篇论文与页面本身,没有应用、接口或开放权重下载的说明。能直接对应的用途,是无配对的跨模态对齐,以及用一次旋转把编码器接成图像描述器。
定理成立的前提写得很具体:正例是同一场景的两次观测,其余偏差有界,两边表征只保证差一次旋转。这些条件同时也标出结论的边界。页面设有限制讨论,但公开摘要没有展开具体失败情形。
常见问题
训练这两个JEPA时需要图文配对吗?
不需要。图像JEPA与文本JEPA完全分开训练,一个看同一场景的不同图像,一个看该场景的不同描述。配对只在事后以一次旋转的形式出现,而且这篇论文强调连这次旋转也可以不靠图文对。
1.09亿参数超过的是哪一类大模型?
超过的是跨模态对齐,不是所有语言能力。对照包括评估中最大720亿参数的语言模型,以及CLIP文本编码器相对DINOv2和CLIP图像编码器的对齐;无配对基准上的对照则是不超过80亿参数的语言模型。