Das Wichtigste in Kürze
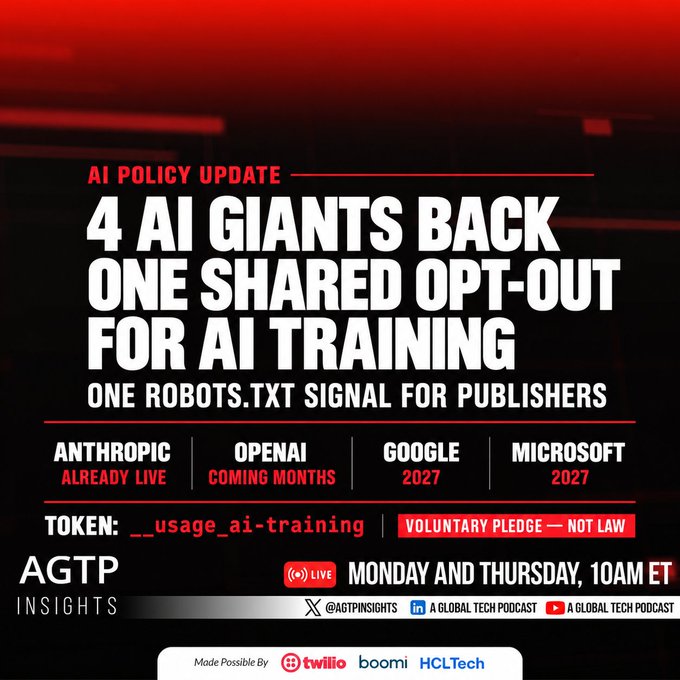
- OpenAI, Google, Microsoft und Anthropic einigen sich auf gemeinsamen robots.txt-Standard (Beteiligte Firmen: OpenAI, Google, Microsoft und Anthropic; Protokolldatei: Einheitliche Direktive in der robots.txt).
- Saubere Trennung zwischen KI-Modelltraining und Live-Suchindexierung (Mechanismus: Blockiert Modelltraining bei vollem Erhalt der KI-Suchsichtbarkeit).
- Wie Website-Betreiber ihre Inhalte schützen, ohne Klicks aus Antwortmaschinen zu verlieren (Gelöstes Problem: Kein Risiko mehr, versehentlich Such-Indexierung auszusperren).
Kurzüberblick
| Beteiligte Firmen | OpenAI, Google, Microsoft und Anthropic |
|---|---|
| Protokolldatei | Einheitliche Direktive in der robots.txt |
| Mechanismus | Blockiert Modelltraining bei vollem Erhalt der KI-Suchsichtbarkeit |
| Gelöstes Problem | Kein Risiko mehr, versehentlich Such-Indexierung auszusperren |
| Kategorie | Tech-Trends |
| Urheber | AGTP |
| Quellenlink | openai.com ↗ |
| Trend-Index | 🔥 261 Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
OpenAI, Google, Microsoft und Anthropic einigen sich auf gemeinsamen robots.txt-Standard
OpenAI, Google, Microsoft und Anthropic unterstützen gemeinsam einen einheitlichen robots.txt-Standard, mit dem Website-Betreiber das KI-Modelltraining per Einzeiler untersagen können, ohne aus der KI-Suche zu verschwinden.
Saubere Trennung zwischen KI-Modelltraining und Live-Suchindexierung
Bisher mussten Seitenbetreiber zahlreiche herstellerspezifische Bot-Namen pflegen und liefen Gefahr, versehentlich auch Such-Indexierung zu blockieren; die neue Direktive trennt Training und Suche sauber.
Wie Website-Betreiber ihre Inhalte schützen, ohne Klicks aus Antwortmaschinen zu verlieren
Betreiber von Content-Seiten können ihre robots.txt im Wurzelverzeichnis aktualisieren, um Massentraining auszuschließen und dennoch Klicks aus KI-Antwortmaschinen zu erhalten.
Häufige Fragen
Was sind die bestätigten Fakten und Hintergründe zu Einheitlicher robots.txt-Standard gegen KI-Training?
Beteiligte Firmen: OpenAI, Google, Microsoft und Anthropic; Protokolldatei: Einheitliche Direktive in der robots.txt; Mechanismus: Blockiert Modelltraining bei vollem Erhalt der KI-Suchsichtbarkeit. Bisher mussten Seitenbetreiber zahlreiche herstellerspezifische Bot-Namen pflegen und liefen Gefahr, versehentlich auch Such-Indexierung zu blockieren; die neue Direktive trennt Training und Suche sauber.
Welche Auswirkungen hat das und wie geht es weiter?
Gelöstes Problem: Kein Risiko mehr, versehentlich Such-Indexierung auszusperren. Betreiber von Content-Seiten können ihre robots.txt im Wurzelverzeichnis aktualisieren, um Massentraining auszuschließen und dennoch Klicks aus KI-Antwortmaschinen zu erhalten.