Puntos clave
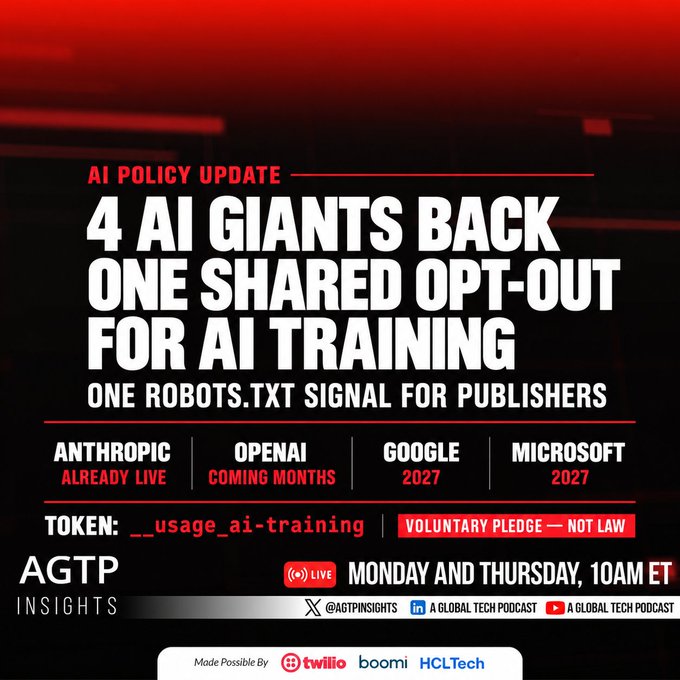
- OpenAI, Google, Microsoft y Anthropic acuerdan un estándar único en robots.txt (Empresas firmantes: OpenAI, Google, Microsoft y Anthropic; Archivo estándar: Directiva unificada en robots.txt).
- Por qué es clave separar el raspado para entrenamiento de la búsqueda en vivo (Mecanismo: Bloquea el entrenamiento masivo manteniendo citas en buscadores de IA).
- Cómo proteger el contenido original sin perder tráfico de citas en buscadores de IA (Problema resuelto: Evita gestionar decenas de bots y bloquear por error la indexación).
Datos rápidos
| Empresas firmantes | OpenAI, Google, Microsoft y Anthropic |
|---|---|
| Archivo estándar | Directiva unificada en robots.txt |
| Mecanismo | Bloquea el entrenamiento masivo manteniendo citas en buscadores de IA |
| Problema resuelto | Evita gestionar decenas de bots y bloquear por error la indexación |
| Categoría | Tech en tendencia |
| Creador | AGTP |
| Enlace original | openai.com ↗ |
| Popularidad | 🔥 261 Popularidad |
| Publicado | |
| Última actualización |
OpenAI, Google, Microsoft y Anthropic acuerdan un estándar único en robots.txt
OpenAI, Google, Microsoft y Anthropic respaldaron conjuntamente un estándar unificado para robots.txt que permite a los sitios web bloquear el entrenamiento de modelos con una sola línea sin perder visibilidad en búsquedas de IA.
Por qué es clave separar el raspado para entrenamiento de la búsqueda en vivo
Antes los editores debían mantener largas listas de bots por proveedor con el riesgo de bloquear por error la indexación en buscadores; el nuevo estándar separa claramente entrenamiento y búsqueda.
Cómo proteger el contenido original sin perder tráfico de citas en buscadores de IA
Los propietarios de sitios de contenido pueden actualizar su archivo robots.txt raíz para excluir el entrenamiento masivo sin renunciar al tráfico procedente de motores de respuesta.
Preguntas frecuentes
¿Cuáles son los hechos confirmados y el contexto de Estándar unificado en robots.txt para excluir entrenamiento de IA?
Empresas firmantes: OpenAI, Google, Microsoft y Anthropic; Archivo estándar: Directiva unificada en robots.txt; Mecanismo: Bloquea el entrenamiento masivo manteniendo citas en buscadores de IA. Antes los editores debían mantener largas listas de bots por proveedor con el riesgo de bloquear por error la indexación en buscadores; el nuevo estándar separa claramente entrenamiento y búsqueda.
¿Qué implicaciones tiene la noticia y qué pasos siguen ahora?
Problema resuelto: Evita gestionar decenas de bots y bloquear por error la indexación. Los propietarios de sitios de contenido pueden actualizar su archivo robots.txt raíz para excluir el entrenamiento masivo sin renunciar al tráfico procedente de motores de respuesta.