一分钟看懂
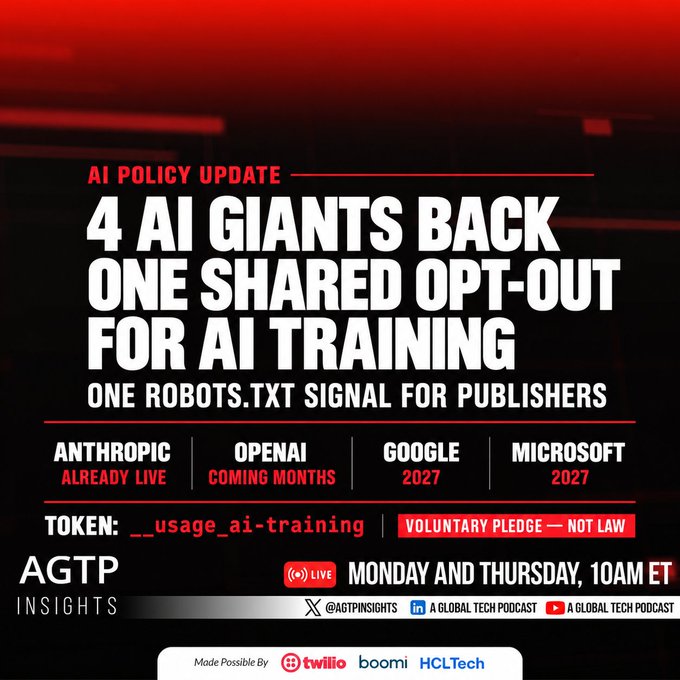
- 四大 AI 巨头首次握手:用一行 robots.txt 统一训练退出标记(联合发起方:OpenAI、Google、Microsoft、Anthropic;协议载体:网站根目录 robots.txt 统一指令标准)。
- 把“预训练抓词料”和“搜索检索引用”彻底解耦意味着什么(核心解耦机制:禁止大模型预训练抓取,但保留 AI 搜索与实时引用曝光)。
- 独立内容站与媒体如何在不丢 AI 搜索流量的前提下保护原创内容(解决痛点:告别维护数十个私有爬虫 UA 与误封搜索收录的风险)。
基本信息
| 联合发起方 | OpenAI、Google、Microsoft、Anthropic |
|---|---|
| 协议载体 | 网站根目录 robots.txt 统一指令标准 |
| 核心解耦机制 | 禁止大模型预训练抓取,但保留 AI 搜索与实时引用曝光 |
| 解决痛点 | 告别维护数十个私有爬虫 UA 与误封搜索收录的风险 |
| 分类 | 科技热点 |
| 作者 / 发布方 | AGTP |
| 报道 / 原文链接 | openai.com ↗ |
| 热度 | 🔥 热度 261 |
| 发布时间 | |
| 数据更新 |
四大 AI 巨头首次握手:用一行 robots.txt 统一训练退出标记
OpenAI、谷歌、微软与 Anthropic 四家公司联合支持一套统一的 robots.txt 训练退出标记标准:站长只需写一条规则,即可禁止网页内容被用于大模型预训练,同时不影响网页在 AI 搜索与实时引用中的曝光。
把“预训练抓词料”和“搜索检索引用”彻底解耦意味着什么
在此之前,内容站站长要想屏蔽训练抓取,不得不维护一长串各家私有的爬虫名称,甚至经常因为配置错误把正常的搜索收录爬虫一并封死。新标准首次在协议层把“模型训练采集”和“搜索检索展现”彻底解耦。
独立内容站与媒体如何在不丢 AI 搜索流量的前提下保护原创内容
对于依赖自然搜索与 AI 回答引用流量的独立内容站而言,现在只需在根目录 robots.txt 中加入统一退训指令,就能在保护原创语料的同时继续承接来自 AI 搜索的点击回流。
常见问题
四巨头联合统一 robots.txt 训练退出标记的核心事实与关键背景是什么?
联合发起方为OpenAI、Google、Microsoft、Anthropic,协议载体为网站根目录 robots.txt 统一指令标准,核心解耦机制为禁止大模型预训练抓取,但保留 AI 搜索与实时引用曝光。在此之前,内容站站长要想屏蔽训练抓取,不得不维护一长串各家私有的爬虫名称,甚至经常因为配置错误把正常的搜索收录爬虫一并封死。
这次事件接下来有哪些后续影响值得关注?
解决痛点为告别维护数十个私有爬虫 UA 与误封搜索收录的风险。对于依赖自然搜索与 AI 回答引用流量的独立内容站而言,现在只需在根目录 robots.txt 中加入统一退训指令,就能在保护原创语料的同时继续承接来自 AI 搜索的点击回流。