핵심 요약
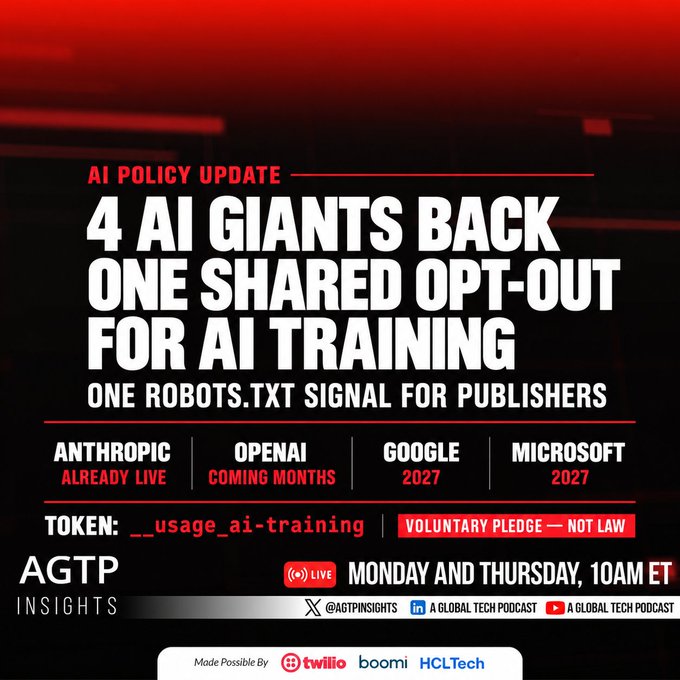
- OpenAI·Google·Microsoft·Anthropic 4개사, 통합 robots.txt 학습 거부 표준 채택 (공동 참여사: OpenAI, Google, Microsoft, Anthropic 4개사, 적용 표준: 루트 robots.txt 통합 옵트아웃 지시어).
- '사전 학습 수집'과 '실시간 AI 검색 인용'을 프로토콜 차원에서 분리한 의미 (핵심 작동 방식: 사전 학습용 데이터 수집만 차단하고 AI 검색 인용 노출은 유지).
- 검색 유입 트래픽을 잃지 않고 오리지널 콘텐츠의 무단 학습만 막는 방법 (해결 과제: 수십 개 봇 UA 개별 관리 부담 및 검색 인덱싱 오차단 방지).
한눈에 보기
| 공동 참여사 | OpenAI, Google, Microsoft, Anthropic 4개사 |
|---|---|
| 적용 표준 | 루트 robots.txt 통합 옵트아웃 지시어 |
| 핵심 작동 방식 | 사전 학습용 데이터 수집만 차단하고 AI 검색 인용 노출은 유지 |
| 해결 과제 | 수십 개 봇 UA 개별 관리 부담 및 검색 인덱싱 오차단 방지 |
| 카테고리 | 테크 화제 |
| 제작자 | AGTP |
| 원문 링크 | openai.com ↗ |
| 화제도 | 🔥 화제도 261 |
| 공개일 | |
| 최종 업데이트 |
OpenAI·Google·Microsoft·Anthropic 4개사, 통합 robots.txt 학습 거부 표준 채택
OpenAI, Google, Microsoft, Anthropic 4개사가 웹사이트 운영자가 단 한 줄의 규칙으로 AI 모델 사전 학습 수집만 거부하고 AI 검색 노출 및 실시간 인용은 유지할 수 있는 통합 robots.txt 표준을 공동 채택했습니다.
'사전 학습 수집'과 '실시간 AI 검색 인용'을 프로토콜 차원에서 분리한 의미
이전에는 퍼블리셔가 수십 개의 기업별 크롤러 이름을 일일이 관리해야 했고 실수로 검색 인덱싱 봇까지 차단하는 일이 잦았으나, 새 표준은 학습 데이터 수집과 검색 참조를 명확히 분리했습니다.
검색 유입 트래픽을 잃지 않고 오리지널 콘텐츠의 무단 학습만 막는 방법
자연 검색과 AI 답변 인용 트래픽이 중요한 웹사이트 운영자는 루트 robots.txt 파일을 업데이트해 본문 학습은 막으면서도 AI 검색 유입 클릭은 그대로 유지할 수 있습니다.
자주 묻는 질문
4대 AI 기업 통합 robots.txt 학습 옵트아웃 표준의 핵심 사실과 주요 경위는 무엇인가요?
공동 참여사는 OpenAI, Google, Microsoft, Anthropic 4개사, 적용 표준는 루트 robots.txt 통합 옵트아웃 지시어, 핵심 작동 방식는 사전 학습용 데이터 수집만 차단하고 AI 검색 인용 노출은 유지입니다. 이전에는 퍼블리셔가 수십 개의 기업별 크롤러 이름을 일일이 관리해야 했고 실수로 검색 인덱싱 봇까지 차단하는 일이 잦았으나, 새 표준은 학습 데이터 수집과 검색 참조를 명확히 분리했습니다.
이번 사안의 후속 영향과 앞으로 주목할 포인트는 무엇인가요?
해결 과제는 수십 개 봇 UA 개별 관리 부담 및 검색 인덱싱 오차단 방지입니다. 자연 검색과 AI 답변 인용 트래픽이 중요한 웹사이트 운영자는 루트 robots.txt 파일을 업데이트해 본문 학습은 막으면서도 AI 검색 유입 클릭은 그대로 유지할 수 있습니다.