要点まとめ
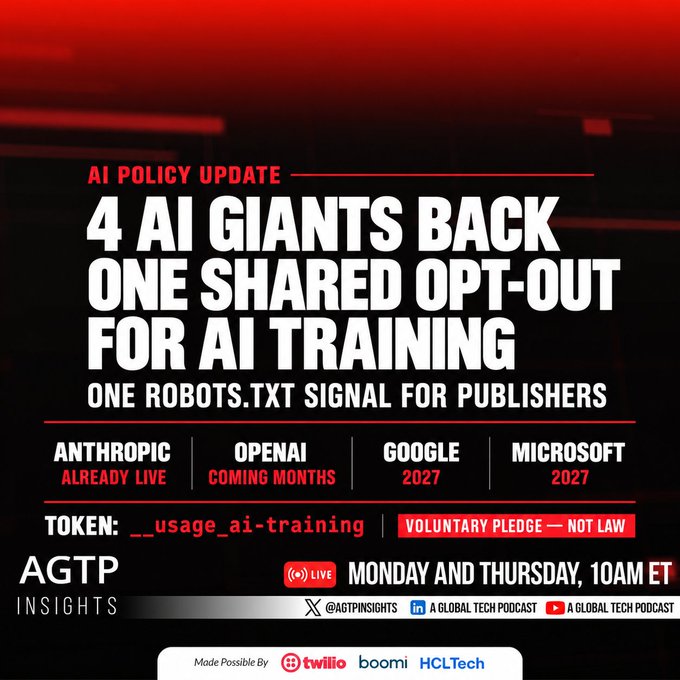
- OpenAI・Google・Microsoft・Anthropicが統一「robots.txt」学習拒否標準を共同支持(共同支持企業:OpenAI・Google・Microsoft・Anthropicの4社/設定ファイル:ルートディレクトリの robots.txt 統一記述)。
- 「モデル学習用スクレイピング」と「AI検索のリアルタイム参照」を切り離す意義(分離の仕組み:事前学習用の収集のみを拒否し、AI検索・引用表示は維持)。
- 検索流入を維持したまま記事の無断学習を防ぐWebサイト運営者の対応策(解決される課題:乱立するクローラー個別指定の手間と検索遮断ミスを解消)。
基本情報
| 共同支持企業 | OpenAI・Google・Microsoft・Anthropicの4社 |
|---|---|
| 設定ファイル | ルートディレクトリの robots.txt 統一記述 |
| 分離の仕組み | 事前学習用の収集のみを拒否し、AI検索・引用表示は維持 |
| 解決される課題 | 乱立するクローラー個別指定の手間と検索遮断ミスを解消 |
| カテゴリ | 話題のテック |
| 作者・提供元 | AGTP |
| 報道・発表元 | openai.com ↗ |
| 注目度 | 🔥 注目度 261 |
| 公開日 | |
| 最終更新 |
OpenAI・Google・Microsoft・Anthropicが統一「robots.txt」学習拒否標準を共同支持
OpenAI、Google、Microsoft、Anthropicの4社は、Webサイト運営者が1行の記述でAIモデルの学習データ収集のみを拒否し、AI検索やリアルタイム引用への表示は維持できる統一「robots.txt」表記標準を共同支持しました。
「モデル学習用スクレイピング」と「AI検索のリアルタイム参照」を切り離す意義
従来は各社ごとに異なるクローラー名を個別に指定する必要があり、誤って検索インデックス用のボットまで遮断してしまう問題がありました。新標準では「学習用データ収集」と「検索・回答時の参照」が明確に分離されます。
検索流入を維持したまま記事の無断学習を防ぐWebサイト運営者の対応策
自然検索やAI検索からの参照流入を重視するメディアや個人サイト運営者は、ルートディレクトリのrobots.txtを更新することで、記事の無断学習を防ぎつつ検索流入を確保できます。
よくある質問
4大AI企業共通「robots.txt」学習オプトアウト規約の事実関係とこれまでの経緯は?
共同支持企業は「OpenAI・Google・Microsoft・Anthropicの4社」、設定ファイルは「ルートディレクトリの robots.txt 統一記述」、分離の仕組みは「事前学習用の収集のみを拒否し、AI検索・引用表示は維持」です。従来は各社ごとに異なるクローラー名を個別に指定する必要があり、誤って検索インデックス用のボットまで遮断してしまう問題がありました。
今後の影響や注目しておくべき続報のポイントは?
解決される課題は「乱立するクローラー個別指定の手間と検索遮断ミスを解消」となっています。自然検索やAI検索からの参照流入を重視するメディアや個人サイト運営者は、ルートディレクトリのrobots.txtを更新することで、記事の無断学習を防ぎつつ検索流入を確保できます。