Das Wichtigste in Kürze
- Clover-35B-A3B-Preview von DiffuSpace Labs ist das erste produktionsreife Open-Weight-Diffusions-Sprachmodell (dLLM) mit 35 Milliarden Gesamtparametern.
- Abgeleitet von Qwen3.6-35B-A3B nutzt es rund 3 Milliarden aktive Parameter pro Schritt, ein 128K-Kontextfenster und die Apache-2.0-Lizenz.
- Durch parallele Generierung, bidirektionale Modellierung und iterative Verfeinerung erzielt es 680 Tokens pro Sekunde auf einer einzelnen GPU-Karte bei BF16-Präzision.
- Die Modellgewichte sind ab sofort auf Hugging Face, ModelScope und über diffuspace.ai abrufbar.
Kurzüberblick
| Modellname | Clover-35B-A3B-Preview |
|---|---|
| Parameter | 35B gesamt / ca. 3B aktiv (auf Basis von Qwen3.6-35B-A3B) |
| Geschwindigkeit | 680 Tokens pro Sekunde auf einer einzelnen GPU bei BF16 |
| Kontext & Lizenz | 128K Kontextfenster, Apache 2.0 Open-Weight-Lizenz |
| Plattformen | Hugging Face (DiffuSpace), ModelScope und diffuspace.ai |
| Kategorie | KI & Modelle |
| Urheber | DiffuSpace |
| Offizielle Seite | huggingface.co ↗ |
| Trend-Index | 🔥 179,6 Tsd. Trend-Index |
| Veröffentlicht | |
| Zuletzt aktualisiert |
Parallele Generierung statt langsamer Wort-für-Wort-Autoregression
Klassische Sprachmodelle arbeiten autoregressiv: Sie erzeugen Text streng sequenziell von links nach rechts, jeweils ein Token nach dem anderen. Selbst auf schnellen Beschleunigern bremst diese serielle Kette den Durchsatz pro Anfrage aus. DiffuSpace – ein 13-köpfiges Forschungsteam, zu dem auf Hugging Face unter anderem Oran Feng, Weitong Lian, Shengliang Deng, Zirui Wu, Guicheng Qi, Demi Zhu, Shansan Gong und Jiacheng Ye gehören – setzt deshalb auf ein Paradigma jenseits der Autoregression.
Als Diffusions-Sprachmodell (dLLM) kombiniert Clover-35B-A3B-Preview parallele Token-Generierung mit bidirektionaler Modellierung und iterativer Verfeinerung. Da mehrere Textpositionen gleichzeitig berechnet und schrittweise geschärft werden, erreicht das Modell auf einer einzigen GPU-Karte bei regulärer BF16-Genauigkeit bis zu 680 Tokens pro Sekunde.
Sparsame 35B-A3B-Architektur auf Basis von Qwen3.6-35B-A3B
Um hohen Durchsatz mit starker Textqualität zu verbinden, baut Clover-35B-A3B-Preview auf dem sparsam aktivierten Modell Qwen3.6-35B-A3B auf. Von den insgesamt 35 Milliarden Parametern werden pro Berechnungsschritt lediglich rund 3 Milliarden aktiviert, was den Speicherbandbreitenbedarf auf einer einzelnen Grafikkarte niedrig hält.
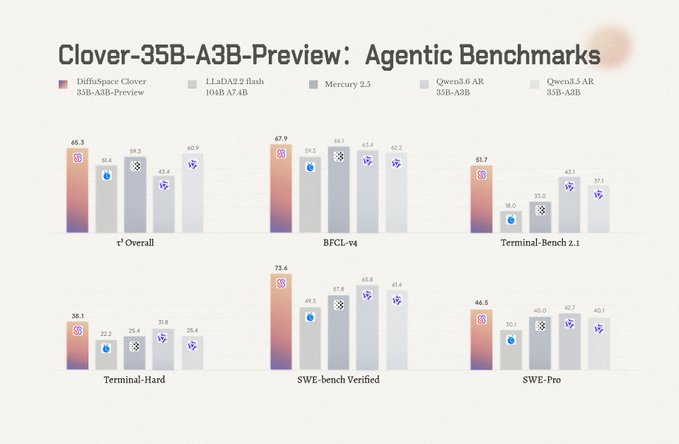
Das Modell verarbeitet ein Kontextfenster von bis zu 128K Tokens und steht unter der wirtschaftsfreundlichen Apache-2.0-Lizenz. Laut DiffuSpace behauptet sich Clover-35B-A3B-Preview in Benchmarks sowohl gegenüber anderen Diffusions-Sprachmodellen als auch gegenüber vergleichbaren autoregressiven Modellen.
- Parallele Generierung
Entwirft mehrere Tokens gleichzeitig statt nacheinander und ermöglicht so 680 TPS auf einer einzelnen BF16-Karte.
- Bidirektionale Modellierung
Bezieht den gesamten Kontext in beide Richtungen ein, was die globale Kohärenz und gezielte Textbearbeitung stärkt.
- Iterative Verfeinerung
Verfeinert den Entwurf über mehrere Diffusionsschritte hinweg bei nur rund 3 Milliarden aktiven Parametern.
Offene Gewichte auf Hugging Face und ModelScope verfügbar
DiffuSpace stellt die Gewichte von Clover-35B-A3B-Preview offen über seine Organisation auf Hugging Face, über ModelScope sowie über die Projektseite diffuspace.ai bereit. Da die Geschwindigkeit von 680 Tokens pro Sekunde direkt in BF16 erreicht wird, sind keine verlustbehafteten Extrem-Quantisierungen nötig, um den Geschwindigkeitsvorteil in der Praxis zu nutzen.
Für Entwicklerteams, die latenzkritische Programmierassistenten, Echtzeit-Textwerkzeuge oder durchsatzstarke Analyse-Pipelines betreiben, bietet Clover-35B-A3B-Preview eine sofort testbare Alternative zur klassischen autoregressiven Dekodierung.
Schritt-für-Schritt-Anleitung
DiffuSpace-Repository auf Hugging Face öffnen
Folgen Sie dem Link oben zur DiffuSpace-Organisation auf Hugging Face (oder ModelScope) und wählen Sie Clover-35B-A3B-Preview aus.
Einzelne GPU mit BF16-Unterstützung bereitstellen
Richten Sie eine GPU-Umgebung ein, die das 35B-Gesamtmodell (ca. 3B aktiv) in BF16 sowie das 128K-Kontextfenster laden kann.
Parallele Diffusions-Inferenz ausführen
Starten Sie die Diffusions-Pipeline und messen Sie den Durchsatz von bis zu 680 Tokens pro Sekunde im Vergleich zu autoregressiven Modellen.
Unter Apache 2.0 in eigene Workflows einbinden
Nutzen Sie die offenen Gewichte lizenzkostenfrei für schnelle Textgenerierung, Code-Vervollständigung oder bidirektionale Editieraufgaben.
Häufige Fragen
Worin unterscheidet sich Clover-35B-A3B-Preview von herkömmlichen Sprachmodellen?
Es ist ein Diffusions-Sprachmodell (dLLM), das Tokens parallel generiert, bidirektional modelliert und iterativ verfeinert, statt sie einzeln von links nach rechts vorherzusagen.
Welche Geschwindigkeit erreicht das Modell auf einer einzelnen Grafikkarte?
Laut DiffuSpace schafft Clover-35B-A3B-Preview bis zu 680 Tokens pro Sekunde (TPS) auf einer einzelnen GPU bei BF16-Präzision.
Auf welchem Basismodell und welcher Lizenz beruht Clover-35B-A3B-Preview?
Es wurde aus Qwen3.6-35B-A3B abgeleitet (35B Parameter gesamt, ca. 3B aktiv, 128K Kontext) und steht unter der Apache-2.0-Lizenz.
Wo lassen sich die Modellgewichte herunterladen?
Die offenen Gewichte sind über Hugging Face (DiffuSpace), ModelScope und die Website diffuspace.ai verfügbar.




