一分钟看懂
- DiffuSpace Labs 推出的 Clover-35B-A3B-Preview 是首个面向生产环境的 35B 级开源权重扩散语言模型(dLLM)。
- 模型基于 Qwen3.6-35B-A3B 改造,总参数量 35B、每次激活约 3B,支持 128K 上下文窗口,采用 Apache 2.0 开源许可。
- 依靠并行生成、双向建模与迭代精炼机制,它在单张 GPU 卡、BF16 精度下可实现每秒 680 token(680 tps)的生成速度。
- 模型权重已同步上线 Hugging Face、ModelScope(魔搭)与 DiffuSpace 官网。
基本信息
| 模型名称 | Clover-35B-A3B-Preview |
|---|---|
| 参数规模 | 总参数 35B / 激活参数约 3B(基于 Qwen3.6-35B-A3B) |
| 推理速度 | 单卡 GPU(BF16 精度)每秒 680 token |
| 上下文与协议 | 128K 上下文窗口,Apache 2.0 开源协议 |
| 获取渠道 | Hugging Face、ModelScope 与 diffuspace.ai |
| 分类 | AI 前沿 |
| 作者 / 发布方 | DiffuSpace |
| 官方入口 | huggingface.co ↗ |
| 热度 | 🔥 热度 17万 |
| 发布时间 | |
| 数据更新 |
跳出从左到右逐字吐词:用并行扩散突破解码瓶颈
目前主流的自回归(AR)大语言模型在生成文本时,必须严格按照从左到右的顺序一个词接一个词地串行预测。无论显卡算力有多充裕,单路生成的速度都会被这种串行依赖卡住。DiffuSpace 是一支 13 人的研究与工程团队(Hugging Face 组织成员包括 Oran Feng、Weitong Lian、Shengliang Deng、Zirui Wu、Guicheng Qi、Demi Zhu、Shansan Gong、Jiacheng Ye 等),他们的目标是构建超越自回归范式的下一代基础模型。
Clover-35B-A3B-Preview 走的正是扩散语言模型(dLLM)路线。它通过并行生成、双向建模与多步迭代精炼来同时更新一整段 token,不再等待前一个词落定才算下一个词。得益于并行解码机制,该模型在单张 GPU 卡、标准 BF16 精度下就能跑出每秒 680 token 的实测吞吐。
脱胎于 Qwen3.6-35B-A3B,兼顾 3B 激活开销与 128K 长窗口
为了在提速的同时守住语言理解与推理质量,DiffuSpace 选择在 Qwen3.6-35B-A3B 稀疏架构基础上进行扩散化改造。模型总参数量为 35B,但实际推理时仅激活约 3B 参数,把显存带宽压力控制在单卡即可轻松承载的范围内。
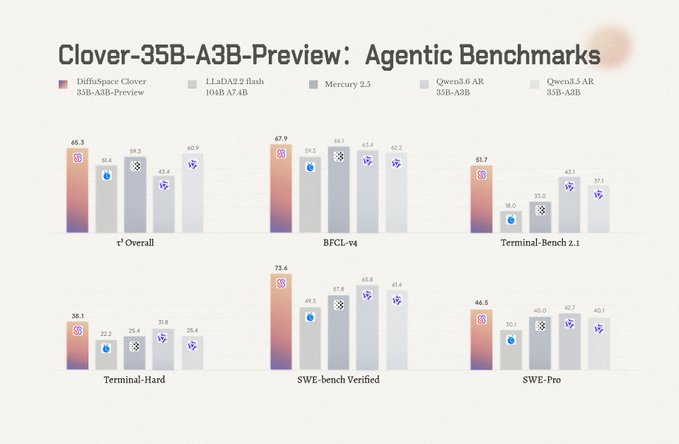
此外,Clover-35B-A3B-Preview 完整保留了 128K 上下文窗口,并以宽松的 Apache 2.0 开源协议释放权重。官方基准测试表明,它在与同类扩散语言模型(dLLM)以及同档位自回归(AR)模型的对比中均展现出扎实的性能。
- 并行生成(Parallel Generation)
一次前向计算可并行预测与修正多个位置的 token,在单卡 BF16 下直达 680 tps。
- 双向建模(Bidirectional Modeling)
生成过程中同时利用上下文双向信息,比单向因果掩码更适合全局结构控制与中间补全。
- 迭代精炼(Iterative Refinement)
通过有限步去噪迭代逐步收紧生成质量,同时依托 3B 激活参数保持轻量计算开销。
权重已在 Hugging Face 与魔搭开放下载
Clover-35B-A3B-Preview 的开源权重已经同步托管在 Hugging Face 的 DiffuSpace 组织主页、ModelScope(魔搭社区)以及官方站点 diffuspace.ai。国内与海外开发者都可以直接拉取权重文件在本地复现。
由于采用 Apache 2.0 许可且无需激进的低比特量化就能在 BF16 下取得每秒 680 token 的高吞吐,需要低延迟代码生成、实时交互式文本改写或大规模批处理推理的团队,可以直接在单卡环境里评测这颗 35B 扩散语言模型的实际表现。
上手步骤
访问 DiffuSpace 模型仓库
通过上方入口前往 Hugging Face 的 DiffuSpace 主页(或 ModelScope 社区),找到 Clover-35B-A3B-Preview 权重仓库。
准备单卡 BF16 推理环境
配置一张可容纳 35B 总参数(约 3B 激活参数)BF16 权重的 GPU 环境,无需多卡张量并行即可启动。
运行并行扩散解码测试
加载官方推理配置,实测其在单卡 BF16 下的每秒 680 token 并行生成速度与 128K 长文本表现。
基于 Apache 2.0 协议集成或微调
结合双向建模与迭代精炼特性,将其接入代码补全、结构化生成或高吞吐批处理业务。
常见问题
Clover-35B-A3B-Preview 和普通自回归大模型有什么区别?
它是扩散语言模型(dLLM),不采用从左到右逐 token 串行生成,而是利用并行生成、双向建模和迭代精炼来同时生成文本。
单卡每秒 680 token 是在什么精度下测出来的?
官方公布的数据是在单张 GPU 卡、标准 BF16 精度下达到每秒 680 token(680 tps)。
它的底座模型和开源协议是什么?
模型基于 Qwen3.6-35B-A3B 改造(总参数 35B、激活约 3B,支持 128K 上下文),采用 Apache 2.0 协议开源。
在哪里可以下载到 Clover-35B-A3B-Preview 的模型权重?
权重已发布在 Hugging Face(DiffuSpace 组织)、ModelScope(魔搭)以及官方网站 diffuspace.ai。




