Puntos clave
- Clover-35B-A3B-Preview, de DiffuSpace Labs, es el primer modelo de lenguaje por difusión (dLLM) de pesos abiertos orientado a producción en la escala de 35B de parámetros.
- Adaptado a partir de Qwen3.6-35B-A3B, cuenta con 35B de parámetros totales, cerca de 3B activos por paso, ventana de contexto de 128K y licencia Apache 2.0.
- Gracias a la generación paralela, el modelado bidireccional y el refinamiento iterativo, alcanza 680 tokens por segundo en una sola tarjeta GPU con precisión BF16.
- Los pesos están disponibles desde hoy en Hugging Face, ModelScope y el sitio oficial diffuspace.ai.
Datos rápidos
| Modelo | Clover-35B-A3B-Preview |
|---|---|
| Parámetros | 35B totales / ~3B activos (basado en Qwen3.6-35B-A3B) |
| Velocidad de inferencia | 680 tokens por segundo en una sola tarjeta GPU en BF16 |
| Contexto y licencia | Ventana de 128K tokens, licencia abierta Apache 2.0 |
| Disponibilidad | Hugging Face (DiffuSpace), ModelScope y diffuspace.ai |
| Categoría | IA y modelos |
| Creador | DiffuSpace |
| Sitio oficial | huggingface.co ↗ |
| Popularidad | 🔥 179,6K Popularidad |
| Publicado | |
| Última actualización |
Más allá de la autorregresión secuencial mediante generación paralela
La gran mayoría de los modelos de lenguaje actuales funcionan de manera autorregresiva: predicen un token tras otro de izquierda a derecha. Ese cuello de botella secuencial limita la velocidad de respuesta aunque la tarjeta gráfica tenga capacidad de cálculo libre. DiffuSpace —un equipo de 13 integrantes entre los que figuran Oran Feng, Weitong Lian, Shengliang Deng, Zirui Wu, Guicheng Qi, Demi Zhu, Shansan Gong y Jiacheng Ye— diseñó Clover-35B-A3B-Preview precisamente para superar el paradigma autorregresivo.
Como modelo de lenguaje por difusión (dLLM), Clover-35B-A3B-Preview genera y depura múltiples tokens en paralelo combinando atención bidireccional y pasos de refinamiento iterativo. Al no tener que esperar a que termine cada palabra para calcular la siguiente, logra una velocidad de 680 tokens por segundo en una sola GPU trabajando en precisión BF16 estándar.
Arquitectura dispersa 35B-A3B sobre Qwen3.6 con 128K de contexto
Para unir esa velocidad de decodificación con una alta calidad lingüística, DiffuSpace partió de la arquitectura dispersa Qwen3.6-35B-A3B. Aunque el modelo almacena 35.000 millones de parámetros en total, solo activa alrededor de 3.000 millones en cada paso, manteniendo un consumo de ancho de banda de memoria apto para una única GPU.
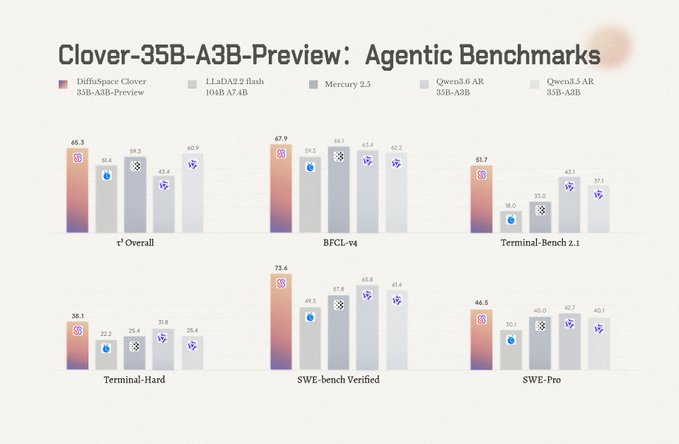
El modelo admite una ventana de contexto de 128K tokens y se distribuye bajo la licencia abierta Apache 2.0. Según los datos de DiffuSpace Labs, Clover-35B-A3B-Preview ofrece un rendimiento competitivo tanto frente a otros modelos de difusión (dLLM) como frente a modelos autorregresivos (AR) de su categoría.
- Generación paralela
Calcula bloques de tokens al mismo tiempo en lugar de ir uno por uno, alcanzando 680 tps en BF16 sobre una sola tarjeta.
- Modelado bidireccional
Aprovecha el contexto en ambas direcciones durante todo el proceso, mejorando la coherencia global y la edición controlada.
- Refinamiento iterativo
Pule las predicciones a lo largo de los pasos de difusión manteniendo el cómputo activo en torno a los 3B de parámetros.
Descarga directa en Hugging Face, ModelScope y diffuspace.ai
Los pesos abiertos de Clover-35B-A3B-Preview ya se pueden descargar desde la organización DiffuSpace en Hugging Face, desde ModelScope y a través de la web oficial diffuspace.ai. Al alcanzar los 680 tokens por segundo directamente en BF16, no obliga a aplicar cuantizaciones agresivas para obtener baja latencia.
Para equipos que desarrollan asistentes de programación en tiempo real, herramientas de redacción interactiva o flujos de inferencia masiva, este lanzamiento permite probar en hardware propio un modelo de difusión de escala de producción con licencia Apache 2.0.
Guía paso a paso
Acceder al repositorio de DiffuSpace
Utilice el enlace superior para abrir la página de DiffuSpace en Hugging Face (o ModelScope) y localizar Clover-35B-A3B-Preview.
Preparar un entorno con una GPU en BF16
Configure una tarjeta GPU capaz de alojar los pesos de 35B totales (3B activos) en BF16 y la ventana de contexto de 128K.
Ejecutar la inferencia por difusión paralela
Lance el flujo de generación del modelo para medir el rendimiento de hasta 680 tokens por segundo frente a modelos autorregresivos.
Integrar el modelo bajo licencia Apache 2.0
Aplique el modelado bidireccional y la alta velocidad de respuesta en sus propios proyectos comerciales o de investigación.
Preguntas frecuentes
¿En qué se diferencia Clover-35B-A3B-Preview de un LLM convencional?
Es un modelo de lenguaje por difusión (dLLM) que emplea generación paralela, modelado bidireccional y refinamiento iterativo en vez de generar texto token por token de izquierda a derecha.
¿Qué velocidad alcanza en una sola GPU?
DiffuSpace informa que el modelo llega a 680 tokens por segundo (tps) en una sola tarjeta GPU utilizando precisión BF16.
¿De qué modelo base parte y qué licencia tiene?
Está adaptado a partir de Qwen3.6-35B-A3B (35B totales, ~3B activos, 128K de contexto) y se publica bajo licencia abierta Apache 2.0.
¿Dónde se pueden descargar los pesos del modelo?
Están disponibles en Hugging Face (organización DiffuSpace), en ModelScope y en el sitio oficial diffuspace.ai.




