핵심 요약
- DiffuSpace Labs가 선보인 Clover-35B-A3B-Preview는 35B 규모 최초의 프로덕션급 오픈웨이트 확산 언어 모델(dLLM)입니다.
- Qwen3.6-35B-A3B를 기반으로 개조되었으며 총 파라미터 35B·활성 파라미터 약 3B, 128K 컨텍스트 윈도우, Apache 2.0 라이선스를 갖췄습니다.
- 병렬 생성, 양방향 모델링, 반복 정제 방식을 통해 단일 GPU 카드 BF16 정밀도에서 초당 680토큰(680 tps)을 처리합니다.
- 모델 가중치는 Hugging Face, ModelScope 및 DiffuSpace 공식 웹사이트에 공개되어 있습니다.
한눈에 보기
| 모델명 | Clover-35B-A3B-Preview |
|---|---|
| 파라미터 구성 | 총 35B / 활성 약 3B (Qwen3.6-35B-A3B 기반) |
| 추론 속도 | 단일 GPU 카드 BF16 기준 초당 680토큰 (680 tps) |
| 컨텍스트 및 라이선스 | 128K 컨텍스트 윈도우, Apache 2.0 오픈웨이트 |
| 배포 채널 | Hugging Face (DiffuSpace), ModelScope, diffuspace.ai |
| 카테고리 | AI·모델 |
| 제작자 | DiffuSpace |
| 공식 사이트 | huggingface.co ↗ |
| 화제도 | 🔥 화제도 17만 |
| 공개일 | |
| 최종 업데이트 |
토큰을 하나씩 잇는 자기회귀를 넘어 병렬 확산 생성으로
기존의 주류 대형 언어 모델은 왼쪽에서 오른쪽으로 한 번에 토큰 하나씩을 순차 예측하는 자기회귀(AR) 방식을 따릅니다. 이 구조에서는 앞선 토큰이 결정되기 전까지 다음 토큰 연산을 마칠 수 없어 하드웨어 여유가 있어도 단일 스트림 생성 속도를 끌어올리는 데 한계가 있습니다. Oran Feng, Weitong Lian, Shengliang Deng, Zirui Wu, Guicheng Qi, Demi Zhu, Shansan Gong, Jiacheng Ye 등 13명의 연구원으로 구성된 DiffuSpace 팀은 자기회귀 너머의 차세대 파운데이션 모델 패러다임을 목표로 삼았습니다.
그 결과물인 Clover-35B-A3B-Preview는 병렬 생성, 양방향 모델링, 반복 정제를 결합한 확산 언어 모델(dLLM)입니다. 여러 토큰을 동시에 생성하고 다듬기 때문에 단일 GPU 카드에서 기본 BF16 정밀도만으로도 초당 680토큰이라는 빠른 처리량을 기록합니다.
Qwen3.6-35B-A3B 기반의 3B 활성 구조와 128K 컨텍스트
높은 생성 속도와 언어 성능을 동시에 확보하기 위해 DiffuSpace는 희소 활성화 구조를 지닌 Qwen3.6-35B-A3B를 바탕으로 모델을 설계했습니다. 전체 파라미터는 35B이지만 실제 추론 단계에서 활성화되는 파라미터는 약 3B 수준이어서 단일 카드 메모리 대역폭 안에서도 여유 있게 돌아갑니다.
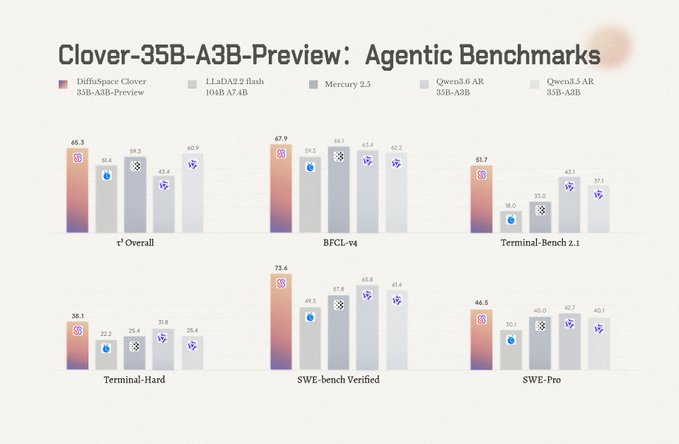
또한 128K 컨텍스트 윈도우를 지원하며 상업적 활용이 자유로운 Apache 2.0 라이선스로 배포됩니다. DiffuSpace 측 벤치마크에 따르면 기존 확산 언어 모델(dLLM)뿐 아니라 동급 자기회귀(AR) 모델과 비교해도 경쟁력 있는 성능을 보여줍니다.
- 병렬 생성 (Parallel generation)
순차적인 단일 토큰 디코딩 대신 여러 토큰을 한꺼번에 생성해 단일 GPU BF16에서 680 tps를 달성합니다.
- 양방향 모델링 (Bidirectional modeling)
문맥의 앞뒤를 양방향으로 참조하며 문장을 구성해 전체 구조 제어와 중간 채우기 작업에 유리합니다.
- 반복 정제 (Iterative refinement)
확산 단계를 거치며 초안 토큰을 점진적으로 다듬어 약 3B 활성 연산량으로 높은 출력 품질을 유지합니다.
Hugging Face와 ModelScope에서 즉시 다운로드 가능
Clover-35B-A3B-Preview의 가중치는 현재 Hugging Face의 DiffuSpace 조직 페이지와 ModelScope, 그리고 공식 사이트 diffuspace.ai에 공개되어 있습니다. 공격적인 저비트 양자화 없이 표준 BF16 정밀도에서 바로 초당 680토큰을 낼 수 있어 로컬 단일 GPU 환경에서 곧바로 실험하기 좋습니다.
반응 속도가 중요한 실시간 코딩 보조 도구나 대량 문서 생성, 양방향 문맥 제어가 필요한 애플리케이션을 개발하는 팀에게 실용적인 오픈웨이트 대안이 됩니다.
단계별 가이드
DiffuSpace Hugging Face 저장소 방문
상단 링크를 눌러 Hugging Face의 DiffuSpace 페이지(또는 ModelScope)에서 Clover-35B-A3B-Preview 가중치를 확인합니다.
단일 BF16 GPU 환경 구성
총 35B(활성 약 3B) BF16 가중치와 128K 컨텍스트를 적재할 수 있는 단일 GPU 환경을 준비합니다.
병렬 확산 추론 속도 벤치마크
확산 디코딩 파이프라인을 실행해 단일 카드 BF16 기준 초당 680토큰 수준의 생성 속도와 응답 품질을 점검합니다.
Apache 2.0 라이선스로 서비스에 통합
양방향 모델링과 고속 병렬 생성의 이점을 살려 코드 생성이나 텍스트 편집 워크플로에 적용합니다.
자주 묻는 질문
Clover-35B-A3B-Preview는 일반 LLM과 어떻게 다른가요?
토큰을 왼쪽에서 오른쪽으로 하나씩 생성하는 자기회귀 모델이 아니라, 병렬 생성·양방향 모델링·반복 정제를 사용하는 확산 언어 모델(dLLM)입니다.
단일 GPU에서 얼마나 빠르게 동작하나요?
BF16 정밀도 기준 단일 GPU 카드에서 초당 680토큰(680 tps)의 생성 속도를 냅니다.
기반 모델과 오픈소스 라이선스는 무엇인가요?
Qwen3.6-35B-A3B를 기반으로 개조되었으며(총 35B, 활성 약 3B, 128K 컨텍스트), Apache 2.0 라이선스로 공개되었습니다.
모델 가중치는 어디에서 받을 수 있나요?
Hugging Face의 DiffuSpace 조직 페이지, ModelScope, 그리고 공식 사이트 diffuspace.ai에서 내려받을 수 있습니다.




