要点まとめ
- DiffuSpace Labsが公開した「Clover-35B-A3B-Preview」は、総パラメータ35B規模で初となる実用レベルのオープンウェイト拡散言語モデル(dLLM)。
- Qwen3.6-35B-A3Bをベースに改造されており、総パラメータ35B・アクティブ約3B、128Kコンテキスト長、Apache 2.0ライセンスを採用。
- 並列生成・双方向モデリング・反復リファインメントにより、単一GPUカードのBF16精度で毎秒680トークン(680 tps)を達成。
- モデルの重みはHugging Face、ModelScope、およびDiffuSpace公式サイトで即日公開されている。
基本情報
| モデル名 | Clover-35B-A3B-Preview |
|---|---|
| パラメータ規模 | 総計35B / アクティブ約3B(Qwen3.6-35B-A3Bベース) |
| 推論速度 | 単一GPUカード(BF16)で毎秒680トークン(680 tps) |
| コンテキスト・ライセンス | 128Kトークン、Apache 2.0オープンウェイト |
| 配布先 | Hugging Face(DiffuSpace)、ModelScope、diffuspace.ai |
| カテゴリ | AI・新モデル |
| 作者・提供元 | DiffuSpace |
| 公式サイト | huggingface.co ↗ |
| 注目度 | 🔥 注目度 17万 |
| 公開日 | |
| 最終更新 |
自己回帰の直列ボトルネックを超える並列生成アプローチ
現在主流の大規模言語モデルは、左から右へと1トークンずつ順番に予測する自己回帰(AR)方式を採用しています。この仕組みは構造上、前のトークンが確定するまで次のステップに進めないため、GPUの演算能力が余っていても単一ストリームの生成速度が頭打ちになりやすい課題がありました。Oran Feng氏、Weitong Lian氏、Shengliang Deng氏、Zirui Wu氏、Guicheng Qi氏、Demi Zhu氏、Shansan Gong氏、Jiacheng Ye氏ら13名のメンバーを擁するDiffuSpaceは、「自己回帰の先へ(Beyond autoregression)」を掲げてこの壁に挑んでいます。
同チームが発表した「Clover-35B-A3B-Preview」は、並列生成・双方向モデリング・反復的な精緻化(イテレーティブリファインメント)を組み合わせた拡散言語モデル(dLLM)です。複数トークンを同時に生成・修正できるため、標準的なBF16精度のまま単一GPUカード上で毎秒680トークンという高いスループットを叩き出します。
Qwen3.6-35B-A3Bを基盤に128KコンテキストとApache 2.0を両立
高速化と出力品質を両立させるため、Clover-35B-A3B-Previewはスパース構造を持つQwen3.6-35B-A3Bをベースに構築されています。総パラメータ数は35Bですが、推論時に活性化するパラメータは約3Bに抑えられており、単一カードでの高速推論に適したメモリ帯域設計となっています。
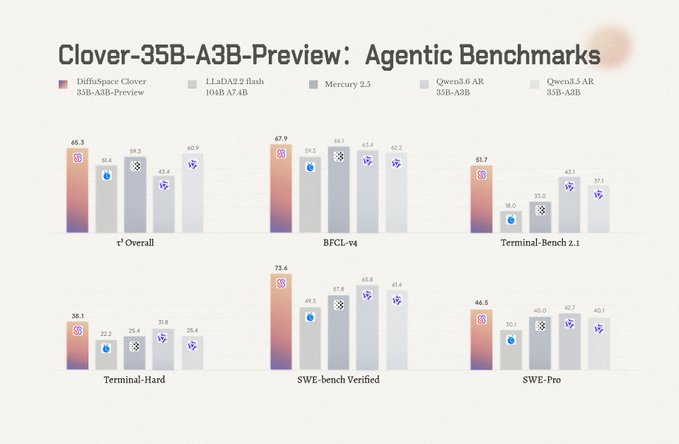
コンテキストウィンドウは128Kトークンに対応し、商用利用もしやすいApache 2.0ライセンスで提供されます。DiffuSpaceの発表によれば、既存の拡散言語モデル(dLLM)だけでなく同クラスの自己回帰(AR)モデルと比較しても強力なベンチマーク性能を示しています。
- 並列生成(Parallel generation)
1トークンずつの逐次出力ではなく複数トークンを並列に生成し、単一GPU・BF16で680 tpsを実現します。
- 双方向モデリング(Bidirectional modeling)
前後の文脈を双方向に参照しながらテキストを組み立てるため、全体の整合性や制御性に優れます。
- 反復的精緻化(Iterative refinement)
拡散ステップを通じて出力を段階的に磨き上げ、アクティブ約3Bの軽量な計算量で高い品質を保ちます。
Hugging FaceとModelScopeで重みを公開中
Clover-35B-A3B-Previewのオープンウェイトは、Hugging FaceのDiffuSpaceオーガナイゼーション、ModelScope、および公式サイトのdiffuspace.aiにて公開されています。極端な量子化に頼らずBF16精度のまま単一カードで680 tpsを出せるため、手元のGPU環境でそのまま速度と精度を検証できます。
低遅延が求められるコーディング支援やリアルタイム文書生成、双方向コンテキストを活かしたテキスト編集など、自己回帰モデルでは速度面で制約があったワークロードの新しい選択肢となります。
ステップ別ガイド
Hugging FaceのDiffuSpaceページを開く
上部のリンクからHugging FaceのDiffuSpaceリポジトリ(またはModelScope)へアクセスし、Clover-35B-A3B-Previewの重みを確認します。
BF16対応の単一GPU環境を用意する
総パラメータ35B(アクティブ約3B)のBF16チェックポイントと128Kコンテキストを扱えるGPU環境を準備します。
並列拡散デコーディングを実行する
拡散言語モデル用の推論パイプラインを動かし、単一カードBF16での680 tps相当のスループットを計測します。
Apache 2.0ライセンスのもとで用途検証する
双方向モデリングや高速生成の特性を活かし、自社のアプリケーションや研究タスクへの組み込みをテストします。
よくある質問
Clover-35B-A3B-Previewは従来のLLMと何が違うのですか?
左から右へ1トークンずつ出力する自己回帰モデルではなく、並列生成・双方向モデリング・反復的精緻化を用いる拡散言語モデル(dLLM)です。
単一GPUでどのくらいの速度が出ますか?
BF16精度の単一GPUカード上で、毎秒680トークン(680 tps)の生成速度を達成したと発表されています。
ベースモデルやライセンスはどうなっていますか?
Qwen3.6-35B-A3Bをベースにしており(総計35B・アクティブ約3B、128Kコンテキスト)、Apache 2.0ライセンスでオープンウェイト公開されています。
モデルの重みはどこから入手できますか?
Hugging FaceのDiffuSpaceページ、ModelScope、および公式サイトdiffuspace.aiから入手できます。




